증명은 밖으로, 모델은 금고 안에
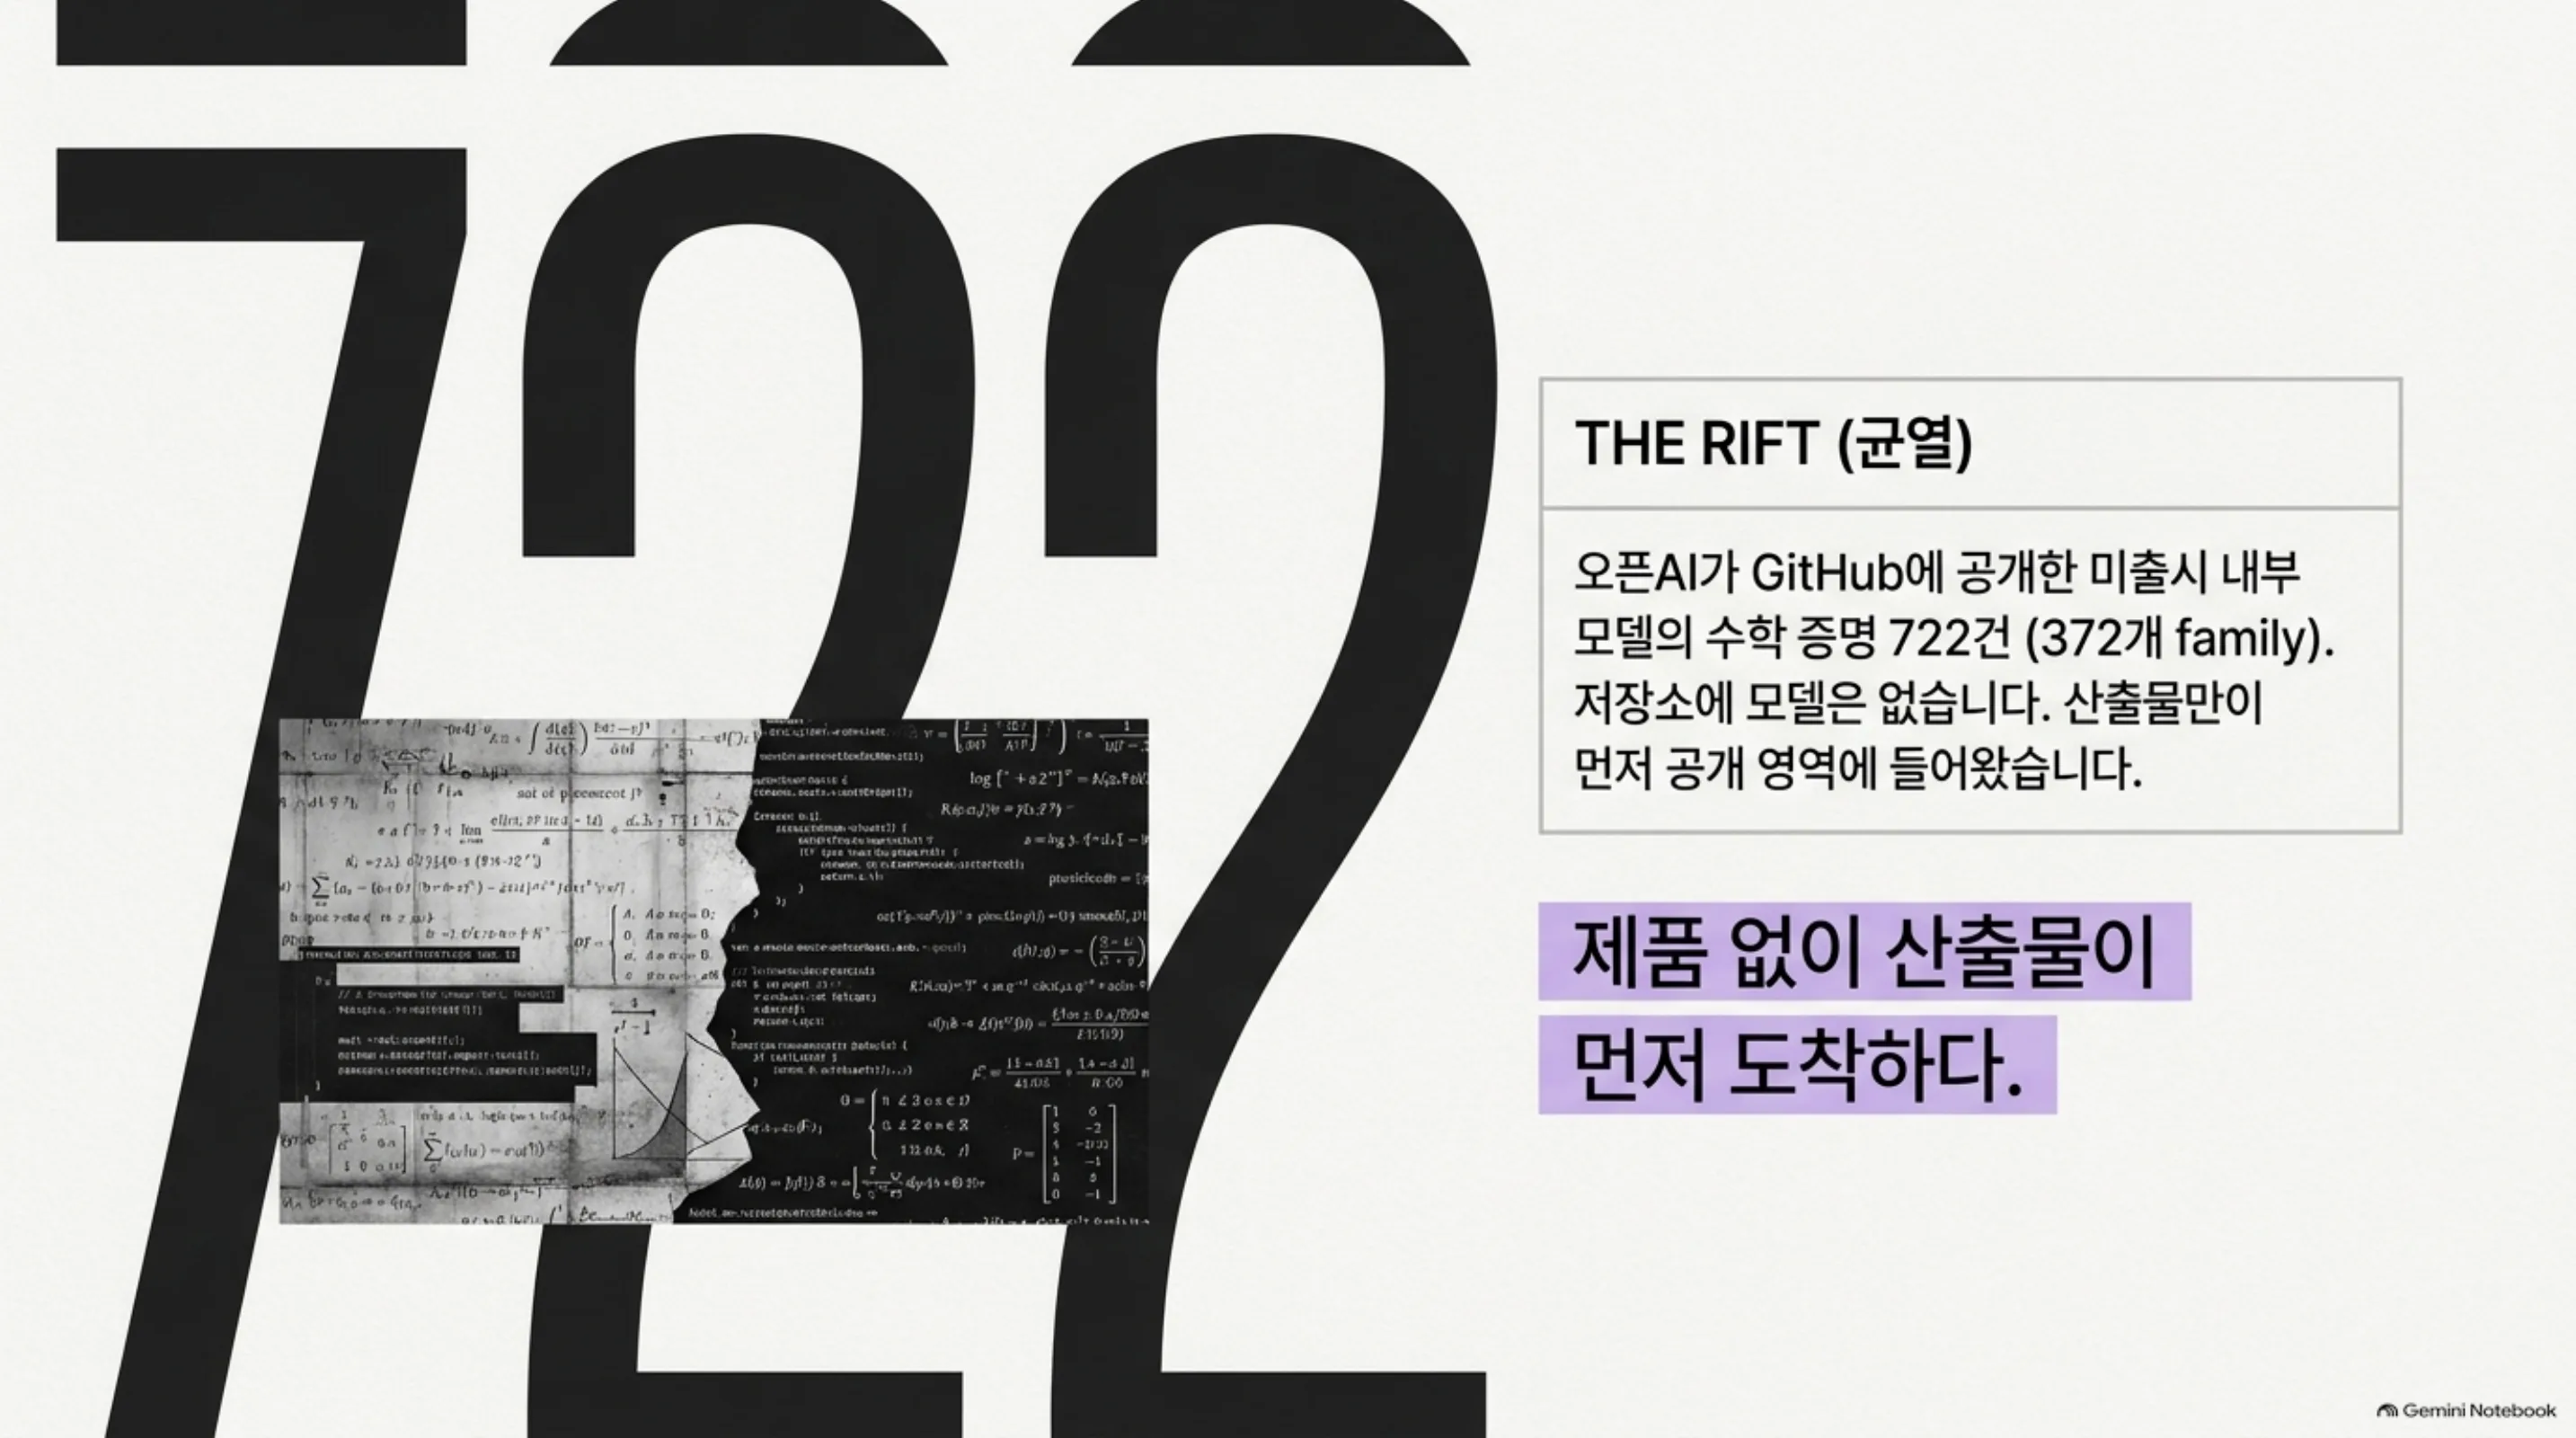
오늘은 수업보다 숙제를 먼저 보자고 제안드립니다. AI 업계의 출시 순서가 조용히 뒤집히고 있기 때문. 그 뒤집힘의 첫 번째 균열은 오픈AI가 GitHub에 올린 수학 증명 722건의 저장소에서 시작됩니다.
저장소에 모델은 없습니다. 새로운 수학 발견 수백 건이 372개 family로 묶여 있고 원고 기준 규모는 722건. 이 산출물을 만든 쪽은 아직 정식 출시되지 않은 오픈AI 내부 모델. 제품 없이 산출물이 먼저 공개 영역에 들어온 것입니다. 증명은 이미 누군가의 검증을 받는 중이고 증명을 쓴 모델만 여전히 금고 안에 있습니다.
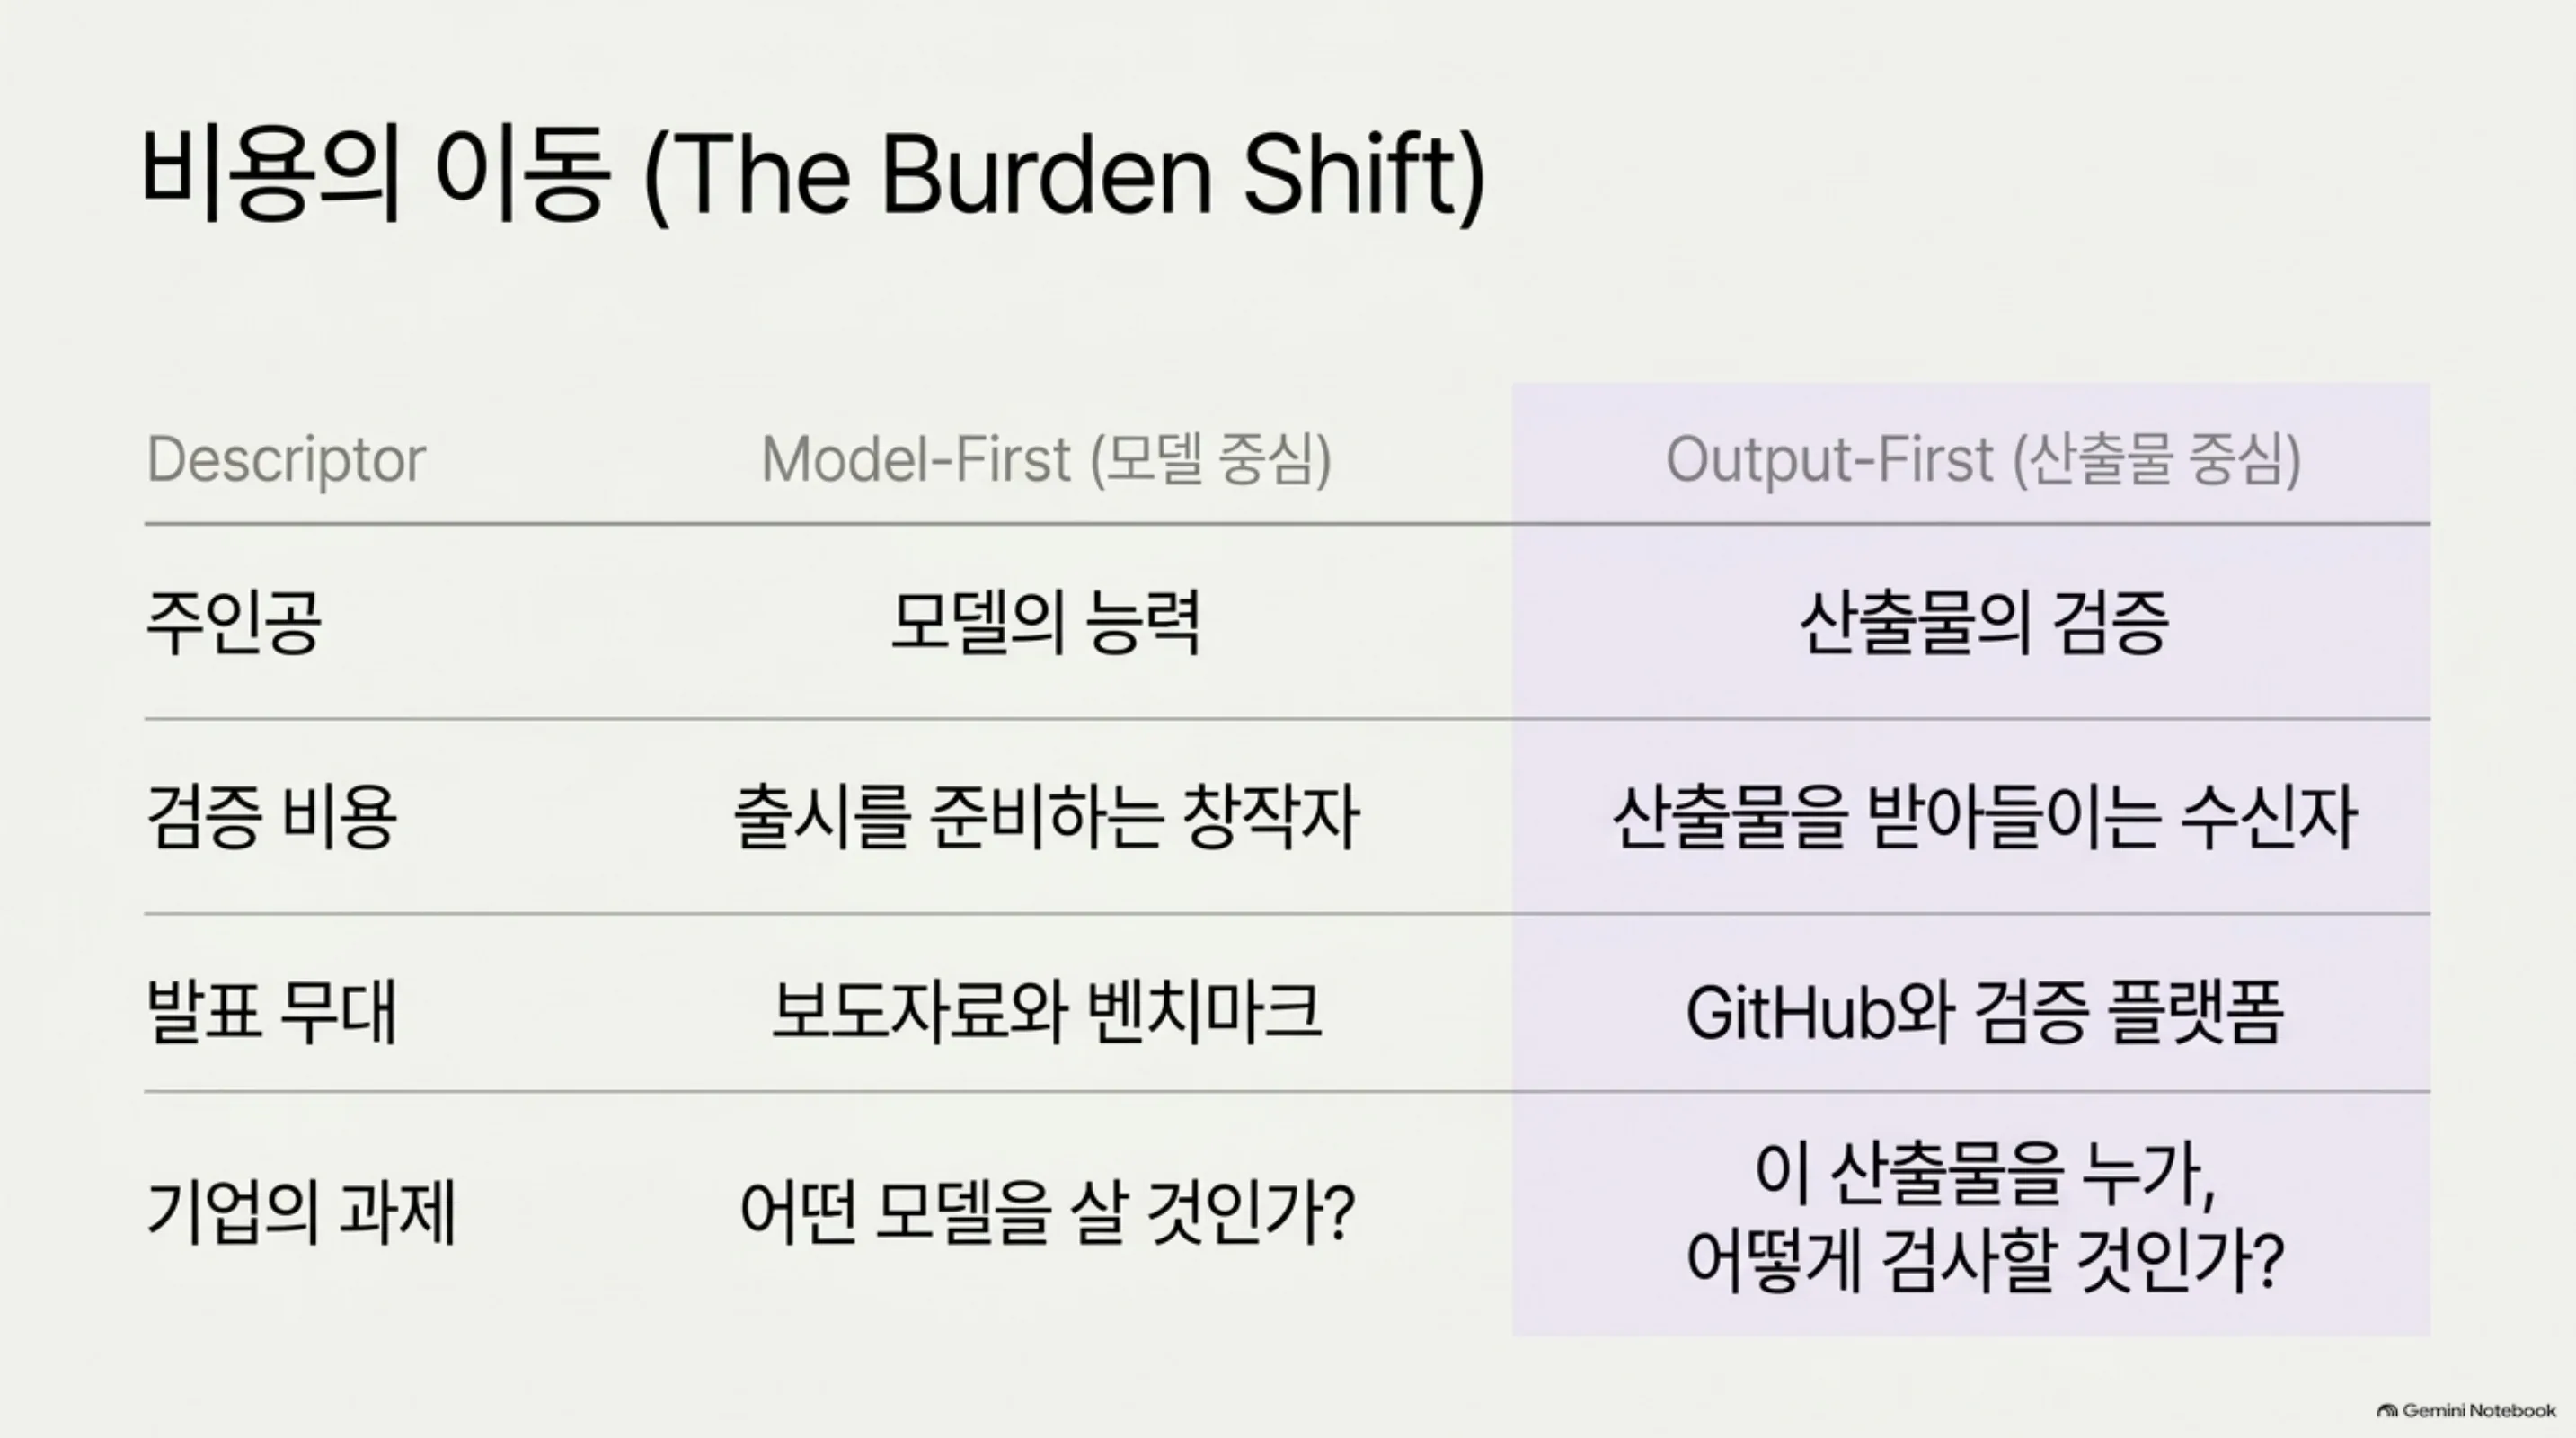
372개 family라는 묶음 자체가 흥미롭습니다. 한두 개의 발견이 아닙니다. 분야를 나눠 나열할 수 있을 만큼의 발견이라는 뜻이기도 합니다. 그리고 공개의 장소가 GitHub. 모델의 벤치마크 점수를 자랑하던 보도자료의 형식도 아닙니다. 코드와 산출물이 검증되는 플랫폼을 무대로 삼았습니다. 발표의 무대가 바뀌면 그 발표가 받는 검증의 종류도 바뀝니다.
‘미출시’라는 단어의 위치가 달라진 셈입니다. 보도자료에서는 늘 미래 시제였습니다. 조만간 나온다는 수식어였는데, 오늘은 헤드라인 한가운데에 서 있는 현재형 명사. 제품이 오기 전에 산출물이 도착하고 검증이 출시보다 앞서 갑니다. 증명은 모든 산출물 중 검증을 가장 분명히 요구하는 종류. 성립하든, 성립하지 않든 판정이 가능하기 때문입니다. 그런 종류의 산출물이 722건씩 쌓여 공개되면, 산업이 묻는 질문은 모델이 얼마나 똑똑한가에서 이 산출물을 누가 어떻게 검사하는가로 이동합니다.
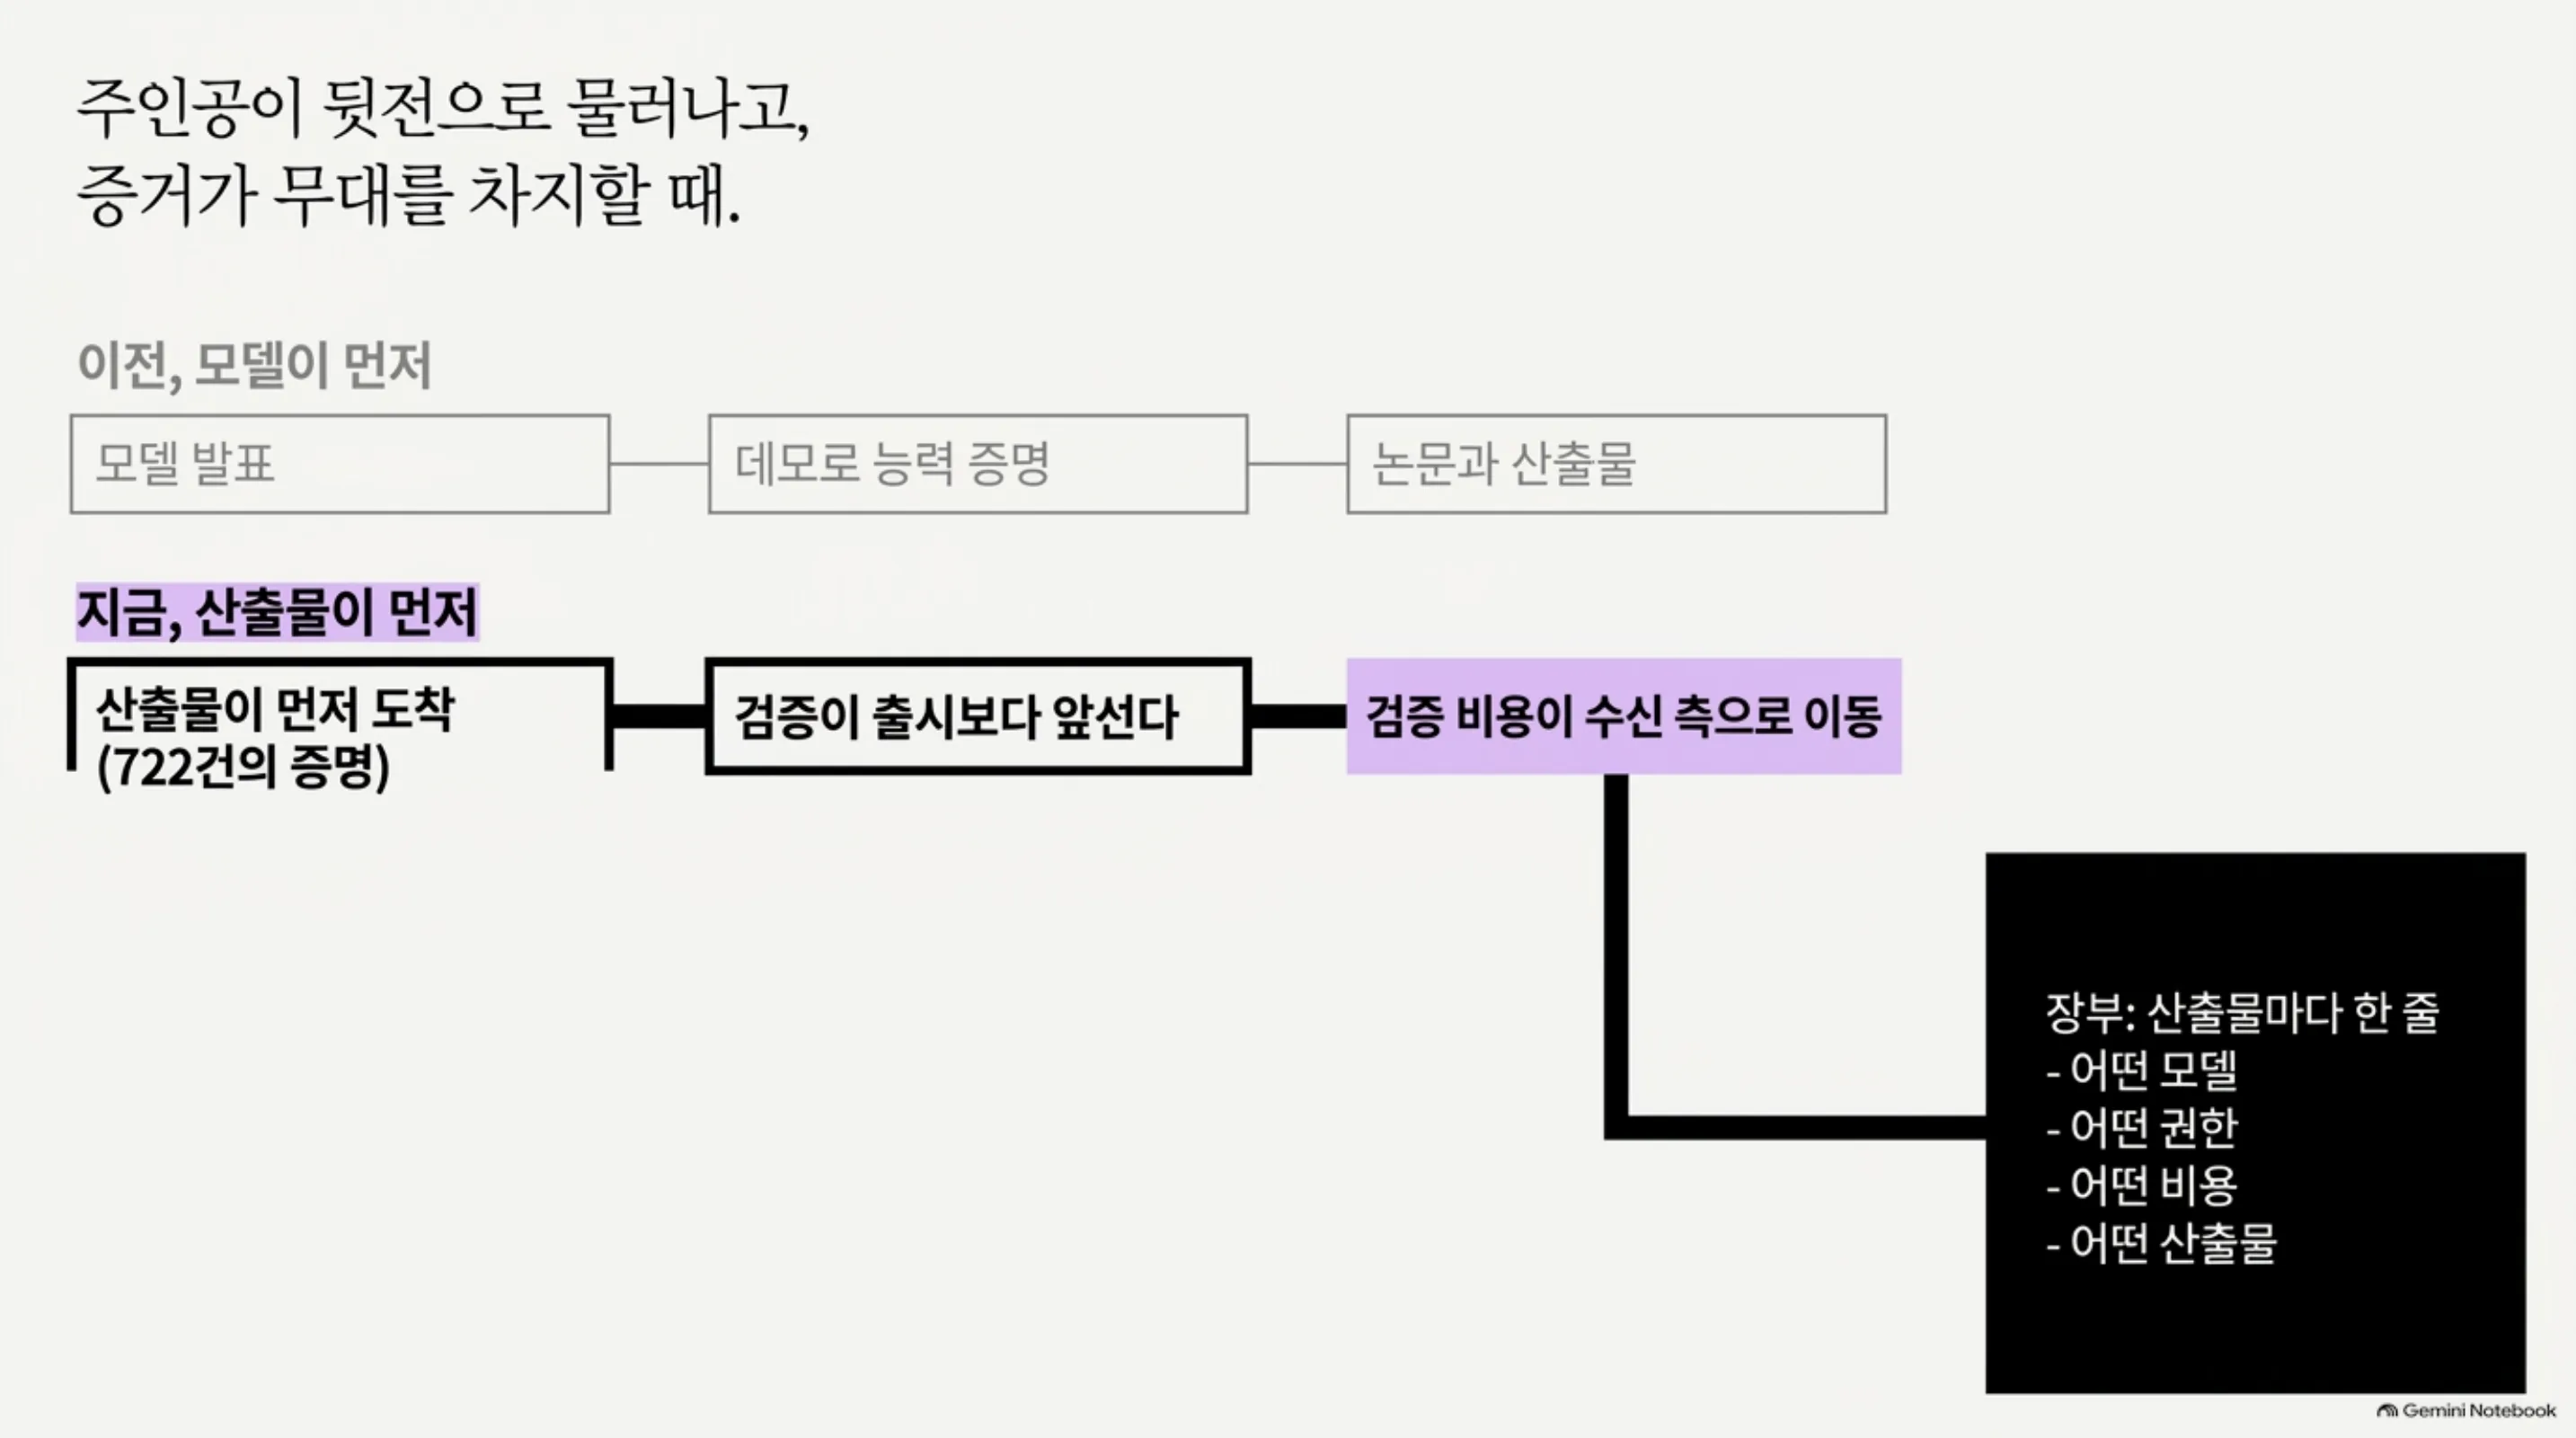
지난 몇 년간 프론티어 랩의 발표 순서는 꽤 고정되어 있었습니다. 먼저 모델을 알리고 데모로 능력을 보여준 뒤 논문과 산출물이 따라왔습니다. 모델이 주인공이었고 산출물은 뒷편의 증거. 오늘은 그 순서가 반대로 돌았습니다. 증거가 먼저 나왔고 주인공은 아직 이름이 없습니다. 발표의 순서가 바뀌면 비용의 부담도 바뀝니다. 능력을 검증하는 비용은 원래 출시를 준비하는 쪽이 짊어졌습니다. 산출물이 먼저 돌기 시작하면, 그 비용은 산출물을 받아들이는 쪽으로 이동합니다. 오늘 다이제스트의 나머지 스토리들은 바로 그 이동의 현장.
한 단계 더 구체적으로 짚어 보겠습니다. 722건의 증명이라는 산출물에는 두 가지가 붙어 다닙니다. 증명을 검사할 기준과, 그 검사를 남길 자리. 산출물을 만든 쪽이 이 둘을 함께 감당하면 큰 문제가 되지 않습니다. 다만 산출물이 먼저 사용 쪽으로 돌기 시작하면, 검사 비용도 같이 이동합니다. 그 지점에서 장부가 주어가 되는 것입니다.
이 뒤집힘을 도식으로 정리하면 다음과 같습니다.
flowchart LR
    subgraph OLD["이전, 모델이 먼저"]
        M1["모델 발표"] --> M2["데모로 능력 증명"] --> M3["논문과 산출물"]
    end
    subgraph NEW["지금, 산출물이 먼저"]
        O1["산출물이 먼저 도착<br/>722건의 증명"] --> O2["검증이 출시보다 앞선다"] --> O3["검증 비용이<br/>수신 측으로 이동"]
    end
    O3 --> L["장부<br/>산출물마다 한 줄"]
    L --> L1["어떤 모델"]
    L --> L2["어떤 권한"]
    L --> L3["어떤 비용"]
    L --> L4["어떤 산출물"]
 증명은 밖으로, 모델은 금고 안에. 이 글의 핵심 개념을 형상화했습니다.
산출물이 몰려온 아침
오늘 다이제스트를 처음부터 끝까지 읽으면, 산출물 쪽은 아침 내내 동시에 움직이고 있습니다.
페플럭시티의 새로운 멀티모달 decision 모델 pplx-decider-v1.1이 Hugging Face Decision Index 0.3 벤치마크에서 1위에 올랐습니다. 비용은 100만 토큰당 2센트, $0.02. 에이전트 워크플로에서 판단 단계는 원래 가장 비쌌습니다. 이제 판단이 소모품이 되는 단가가 된 것입니다. 판단이 2센트가 되면 에이전트는 판단을 더 자주 돌립니다. 판단의 횟수가 늘면 판단의 기록도 늘고 그 기록의 규모가 곧 운영의 비용이 됩니다.
구글의 Nano Banana 2.1은 최신 이미지 생성, 편집 도구. Pro 모델보다 4배 낮은 비용에 성능에서 앞서며, AI Studio와 Google Cloud, Gemini 앱에서 사용할 수 있습니다. 공식 rollout은 확장 중. 품질은 한 단계를 뛰고 가격은 두 단계를 내리는 아침. 이미지는 텍스트와 다릅니다. 오답이 눈에 덜 띄고 쓰이는 표면이 넓기 때문입니다. 그런 산출물이 4배 싼 가격에 더 좋아지면, 쓰는 쪽의 장부보다 막는 쪽의 장부가 먼저 커집니다.
구글과 Google DeepMind는 EmbeddingGemma 2를 내놓았습니다. 최초의 오픈 멀티모달 임베딩 모델로 소개됩니다. 비디오 58프레임, 또는 오디오 5.5분을 한 번의 패스에 처리할 수 있고 로컬 검색, 리트리벌 워크로드를 겨냥합니다. 임베딩이 원격 API의 전유물이 아니라 로컬에 내려놓을 수 있는 물건이 된 것입니다. 수신 쪽에서 말하는 로컬은 성능의 문제가 아닙니다. 가리키는 것은 경계. 데이터가 밖으로 나가지 않는 환경에서 멀티모달 검색을 돌릴 수 있다는 뜻입니다.
미스트랄 Large 4는 Artificial Analysis Intelligence Index에서 38점을 기록했습니다. 미국과 중국 외에서 만든 AI 시스템 중 가장 높은 점수. 제목에서는 이 모델을 ‘Le Chonk’라고 부릅니다. 비미국, 비중국 모델이 지수 1위라는 사실은 공급의 단일화에 제동을 겁니다. 데이터가 머물 자리를 고민하는 기관에는 메뉴가 하나 더 늘어난 아침.
네 스토리를 나란히 놓으면 공통점이 나옵니다. 전부 산출물이 분배 메커니즘보다 먼저 도착한 아침. 판단은 2센트가 됐지만 판단을 어디서 돌릴지는 정해지지 않았습니다. 이미지는 더 좋아졌지만 막아야 할 표면도 넓어졌습니다. 임베딩은 로컬에 내려올 수 있지만 멀티모달 검색을 어떤 정책으로 돌릴지는 아직 각 기업의 몫. 소버린 1위 모델은 메뉴에 왔고 메뉴를 고르는 기준은 아직 메뉴에 없습니다. 산출물의 도착은 수신 절차의 공백을 하나씩 드러내는 일.
수신 쪽에서 그려지는 표준
수신 쪽도 움직입니다. 다만 형태가 다릅니다. 수신 쪽은 산출물을 쌓지 않습니다. 수신 쪽이 그리는 것은 규칙.
메타와 시에라는 개인 AI 에이전트 상호작용을 위한 오픈 스탠다드를 발표했습니다. 월마트와 쇼피파이가 컨소시엄에 합류했고 목표는 디지털 어시스턴트가 기업 시스템과 상호작용하는 방식을 통합하는 것입니다. 역전으로 읽으면 이 스토리는 정확히 다른 반쪽. 에이전트의 산출물이 이미 기업의 문을 두드리고 있고 표준은 그 문에 손잡이를 만듭니다. 두드림이 먼저고 손잡이가 나중입니다.
이 에이전트는 개인의 것입니다. 개인을 대신해 움직이는 에이전트가 기업 시스템에 손을 뻗으면, 기업은 두 질문을 동시에 받아야 합니다. 누구를 대신해서인지, 그리고 어디까지를 허용할 것인지. 표준은 결국 이 두 질문에 대한 답을 한 군데로 모읍니다. 이미 에이전트를 돌리고 있는 기업에게는 먼 생태계 이야기가 아닙니다. 내일 자신의 시스템으로 이어질 문에 대한 질문입니다. 유통과 상거래 플랫폼이 함께한다는 것은, 표준의 대상이 개발자 문서가 아니라는 뜻이기도 합니다. 표준이 향하는 곳은 실제 사업 시스템.
수신의 화폐는 가격이기도 합니다. ChatGPT의 미국 유료 구독자 수는 Claude와 Gemini의 3배. 그런데 미국 성인의 5% 미만만이 AI 어시스턴트에 돈을 지불합니다. 채택은 넓고 지갑은 좁죠. 3배라는 격차가 말하는 것은 시장 구조. 하나의 산출물이 앞서가고 나머지가 따라가는 구도. 그런데 전체에서 돈을 내는 비율이 5% 미만이면, 앞선 쪽의 격차도 아직 가격으로 고정되지 않은 상태입니다. 산출물의 격차는 컸고 수신은 아직 시작 단계죠.
세 번째 화폐는 신뢰입니다. 미 국방부는 자율무기와 대규모 감시를 둘러싼 방제(safeguards) 충돌로, Claude 개발사 Anthropic과 결별했습니다. 대신 구글과 OpenAI를 투입한 것입니다. 세계 최대의 매수자가 방제 기준이 맞지 않아 공급자를 갈아치운 사례. 점수로는 설명되지 않습니다. 통제의 문턱 문제입니다. 계약의 기준은 그 모델의 산출물을 어디까지 허용할 것인가로 넘어갔습니다. 같은 순서가 기업의 에이전트 도입에서 반복될 가능성은 높습니다.
세 화폐가 동시에 늦으면 어떤 일이 일어납니까. 산출물은 들어오고 문은 없습니다. 기업의 에이전트 도입에서 이 장면은 이미 익숙하지요. 표준이 없으면 각 팀이 각자의 커넥터를 만들고 가격이 없으면 예산표에 AI 비용이 없는 것처럼 보이며 신뢰가 없으면 사고가 난 뒤에야 통제 항목이 생깁니다. 수신 쪽이 표준을 그리는 아침은, 그 세 장면이 동시에 시작하는 아침이기도 합니다.
산출물이 먼저 오는 기업의 장부
기업은 산출물이 먼저 도착하는 세계에서 어떤 장부를 갖고 있어야 합니까. 질문은 모델의 구매가 아닙니다. 기록하고 막고 라우팅할 수 있느냐가 문제의 핵심이죠. 새 산출물이 들어올 때마다 장부에 한 줄씩 추가됩니다. 한 줄에 적히는 것은 정해져 있습니다. 어떤 모델이, 어떤 권한으로, 어떤 비용으로, 어떤 산출물을 만들었는지. 관리할 모델이 하나 더 생기고 승인할 권한이 하나 더 늘고 추적할 비용이 하나 더 붙습니다.
장부가 없는 조직에서는 그 속도를 그대로 참아냅니다. 권한은 스크립트 안에 흩어져 있고 비용은 매번 청구서에서 처음 알게 됩니다. 무엇이 실행됐는지는 터미널 히스토리를 뒤져야 나오는 부분. 산출물이 늘수록 이 셋은 곱으로 커집니다. 관리할 모델이 두 배가 되면, 승인할 권한과 추적할 비용은 그 곱만큼 늘어날 수 있습니다. 장부가 없다는 것은 통제를 안 한다는 뜻이 아닙니다. 비용은 사라지지 않고 나중에 한 번에 몰려 올 뿐.
Paxis는 이 장부를 인프라로 만들어 둔 제품입니다. ThakiCloud의 Agent-Native Cloud이며, v1.1 GA의 정식 제품. Skills, Tools, Policies, Audit Logs가 일급 리소스. 일급 리소스라는 말은, 에이전트가 쓰는 스킬과 도구, 정책과 로그가 플랫폼의 객체로 등록되어 관리된다는 뜻. 메모나 파일이 아닙니다. 권한과 버전이 있는 리소스로 존재합니다. 자율도 L0에서 L3까지가 에이전트의 이동 범위를 거버넌스하고 정책 게이트와 감사 로그가 실행 전후로 무엇을, 어떤 권한으로 했는지를 남깁니다. 실행은 격리 샌드박스에서 진행되고, MCP 커넥터와 스킬 마켓이 표준의 흐름을 흡수합니다. 작업별 모델 선택을 CostRouter가 맡으며 소버린 온프레미스 K8s 배포인 ai-platform은 데이터를 기업 안에 머물게 합니다.
오늘 다이제스트는 이 장부에 하나씩 대응됩니다. 모델보다 먼저 도착한 722건의 증명은, 산출물이 감사를 요구하는 이유 그 자체. 정책 게이트가 어떤 자율도에서 어떤 모델이 어떤 작업을 수행할 수 있는지 실행 전에 정하고 감사 로그가 무엇이 실행됐느냐는 질문에 답합니다. 2센트 판단 모델, 4배 싼 이미지 모델, 오픈 멀티모달 임베딩, 소버린 1위 모델. 모델 메뉴가 매주 넓어지면, 작업별 선택은 판단이 아니라 운영이 됩니다. 그 운영을 CostRouter가 기계화합니다. 메타와 시에라의 스탠다드와 MCP 생태계는 인터페이스의 문제이고 커넥터와 스킬 마켓이 그 문턱을 흡수합니다. 개인을 대신한 에이전트와 기업을 대신한 에이전트가 하나의 시스템 앞에서 만나는 순간, 권한의 경계는 플랫폼의 리소스가 되어야 하지요. 국방부의 공급자 교체는 신뢰가 전환 비용임을 보여 줍니다. 모델의 점수를 따라 공급자를 바꾸는 일과, 바꿔도 산출물이 같은 기준으로 감사되는 일은 다른 일. 격리 샌드박스와 온프레미스 배포는 후자를 가능하게 합니다.
증명은 밖으로, 모델은 금고 안에. 이 상태가 예외가 아니라 규칙이 되는 아침. 산출물이 먼저 도착하는 세계에서 기업에 남은 준비는 두 가지. 어떤 산출물이, 어떤 권한으로, 어떤 모델에서 나왔는지를 아는 장부. 그리고 그 장부를 쓰는 비용이 산출물의 이익보다 작도록 설계된 구조. 출시 순서가 뒤집히는 업계에서, 앞서 준비할 수 있는 건 장부뿐입니다.
참고 자료
이 글은 아래 뉴스를 종합해 작성했습니다.
- HuggingNews, OpenAI Releases 722 Math Proofs from Unreleased Internal Model
- HuggingNews, Mistral Le Chonk Tops Intelligence Index for Non-US and China AI
- HuggingNews, Google Nano Banana 2.1 Beats Pro Model at 4x Lower Cost
- HuggingNews, Google Launches EmbeddingGemma 2 as First Open Multimodal Embedding Model
- HuggingNews, Meta and Sierra Launch Open Standard for Personal AI Agent Interaction
- HuggingNews, ChatGPT’s U.S. Paid Subscribers Triple Those of Claude and Gemini
- HuggingNews, Perplexity New v1.1 Decision Model Tops Hugging Face Index at $0.02 per Million Tokens
- HuggingNews, Pentagon Hires Google and OpenAI to Replace Anthropic AI