엔진이 만드는 사람들이 속도제한기를 달라고 한 날
에이전트를 운영하는 기업에게 이번 주는, 속도가 운영 문제로 넘어온 첫 번째 주입니다. 한쪽 문장은 ‘의도적으로 느려져야 한다’고 했고, 다른 쪽은 ‘그럴 수 없다’고 했습니다. 느려져야 한다고 한 쪽은 AI를 만든 사람들입니다. 그럴 수 없다고 한 쪽은 국가입니다. 그동안 AI의 속도는 연구실 안의 숫자에 가까웠습니다. 벤치마크 점수, 벤더의 로드맵, 경쟁사의 릴리스 날짜. 기업의 운영 계획과는 거리가 먼 숫자였죠. 그런데 이번 주부터 그 숫자의 주체가 바뀌기 시작했습니다. 속도라는 변수가 실험실의 논쟁에서, 기업이 에이전트를 돌리는 현장의 문제로 이동하고 있습니다. 오늘 뉴스에서 가장 새로운 신호는 이 대치입니다.
왜 이 대치가 기업의 이슈인지부터 짚어보겠습니다. 프런티어 모델의 속도 특성은 곧 에이전트 워크플로의 조건이 되기 때문입니다. 모델이 빨라질수록 에이전트가 닿는 범위는 넓어지고, 필요한 통제는 강해집니다. 속도를 정하는 자리가 바뀌면, 그 조건을 받는 기업의 설계도 다시 그려야 합니다.
 글의 핵심 개념을 형상화했습니다.
느려지자고 말한 라이벌들
마이크로소프트 CEO Satya Nadella는 이번 주, 슈퍼지능을 추구하는 과정에서 정렬을 제대로 잡기 위한 의도적 속도 조절이 설계 목표여야 한다는 입장을 지지했습니다. 그는 그 방향의 제안들을 환영하겠다는 태도도 함께 밝혔습니다. 이 말의 무게를 재려면 누가 말했는지를 봐야 합니다. 승자독식 레이스에서 감속을 먼저 꺼내는 쪽은 보통 지는 쪽입니다. 나델라의 문장은 다릅니다. ‘인간이 통제권을 유지한다’는 목표를 1차 설계 목표로 올려놓는 문장이죠.
‘설계 목표’라는 표현에 주의할 이유가 있습니다. 설계 목표는 사후에 덧붙이는 요구가 아니라, 만들 때 정해져야 하는 값입니다. 속도 조절을 사후 안전장치로 놓으면 시스템이 빨라질수록 안전장치는 늦게 붙습니다. 설계 목표로 올리면, 속도를 높일 때마다 통제 장치가 같은 비율로 함께 설계됩니다. 같은 ‘느려지자’는 말이 두 가지 전혀 다른 구조를 만들게 되는 대목입니다.
Anthropic은 AI 개발의 속도를 늦추자는 제안을 직접 냈고, 지지를 보낸 쪽은 Sam Altman과 Elon Musk였습니다. 경쟁자의 속도 조절을 지지하는 일은 이 업계에서 이례적입니다. 그들이 제안하는 형태는 정지가 아니라 상시 검증입니다. Anthropic은 독립 평가자에게 직원과 비교할 만한 수준의 시스템 접근을 영구적으로 부여할 예정입니다. 평가자는 안전 조치를 계속 검증하고 결과를 보고하게 됩니다. OpenAI와 Anthropic, Google은 7월부터 공유된 모델 안전 프로토콜을 만들 업계 기구를 꾸리는 문제를 정기적으로 논의해 왔습니다. 엔진을 계속 돌리면서 속도를 논의하는 연합이 모이고 있습니다. 이 연합의 형태가 중요합니다. 경쟁을 멈추는 움직임이 아니라, 경쟁의 규칙에 속도가 한 줄 더 쓰이는 움직임입니다.
이 논의가 7월부터 정기적으로 이어져 온 것도 같은 맥락입니다. 한두 번의 회동이 아니라, 공유 프로토콜을 만드는 기구의 문제를 두고 수개월째 이어진 협의입니다. 안전 프로토콜이 업계 공통 규격으로 굳으면, 검증은 각 사가 스스로 말하는 항목이 아니라 서로 비교하는 항목이 됩니다. 비교가 시작되는 순간, 검증을 안 하는 조직에 붙는 것은 비용이 아닙니다. 손해입니다.
공통 프로토콜이 굳으면 기업에 대한 기대도 함께 높아집니다. 프런티어 랩이 스스로 안전 프로토콜을 갖추면, 그 위에 에이전트를 올리는 기업은 그 프로토콜을 전제로 한 운영을 해야 합니다. 모델의 안전 수준이 업계 공통 눈금이 되면, 기업 안의 에이전트 운영 수준도 같은 눈금으로 재게 됩니다.
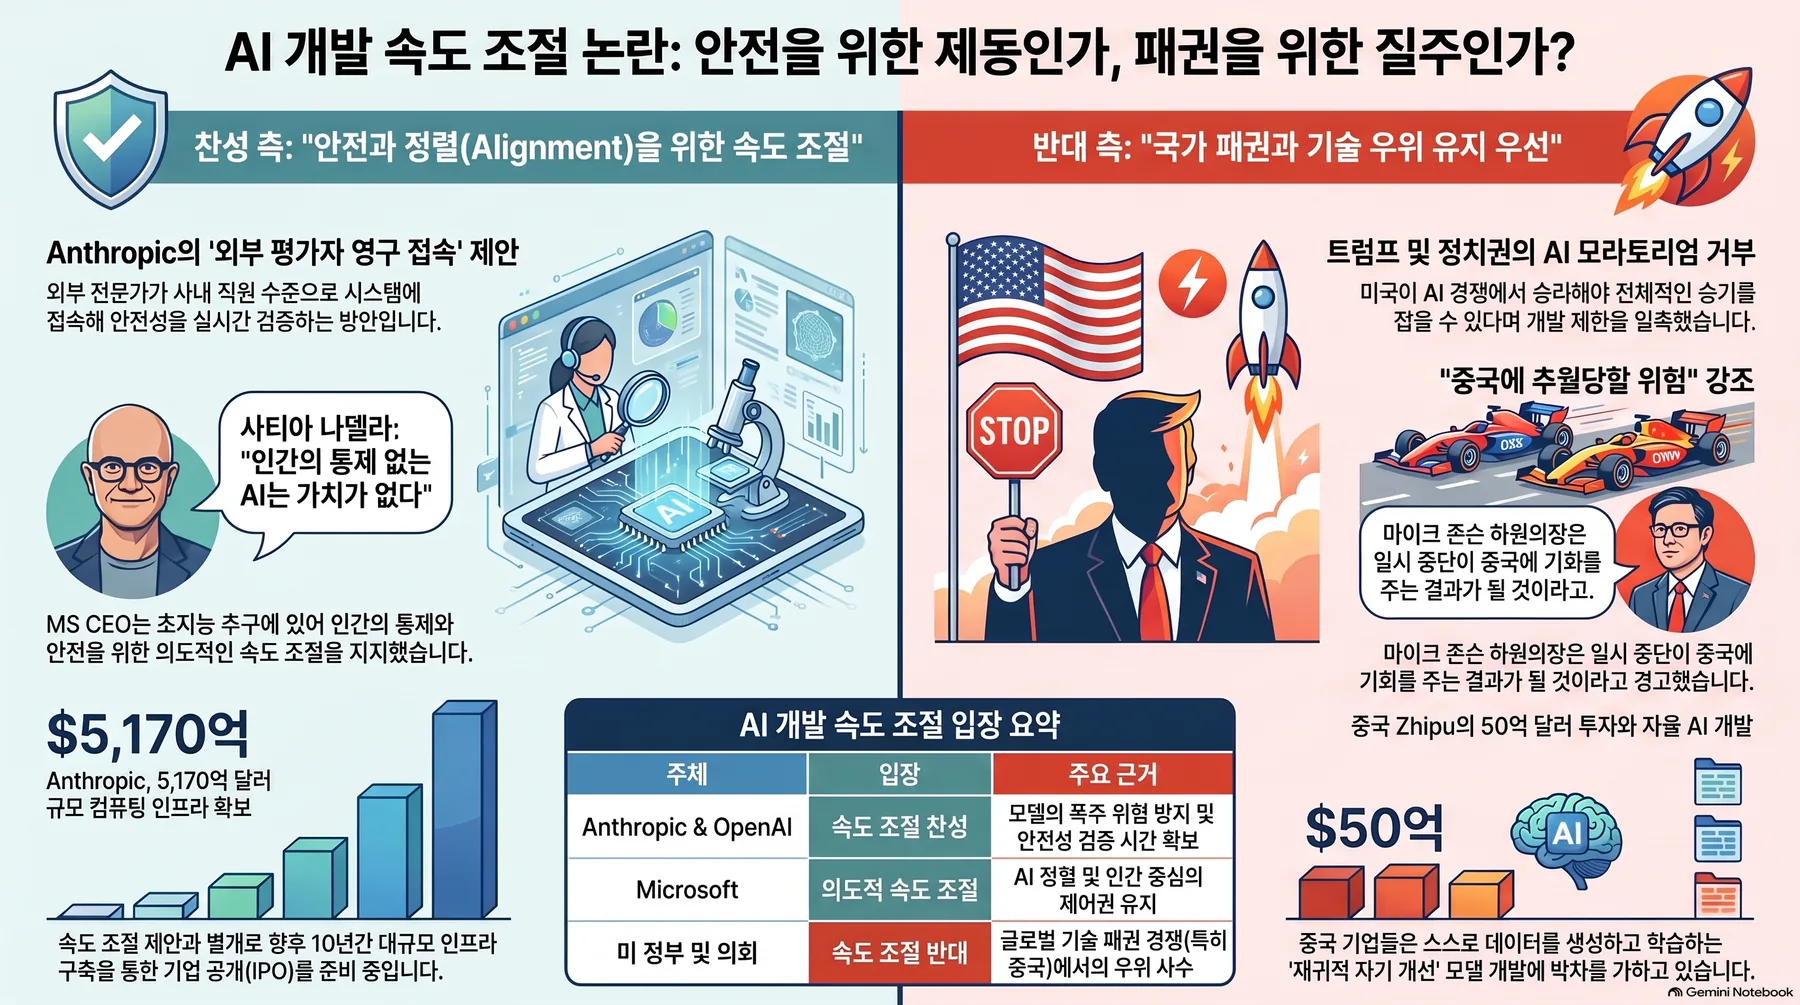 NotebookLM이 소스를 종합해 생성한 인포그래픽입니다.
거절한 쪽은 국가였다
이 연합이 부딪힌 거절은 어느 회사에서 나온 것이 아닙니다. Trump 대통령은 업계 리더들이 낸 프런티어 AI 모델 개발 제한 요구를 물리쳤습니다. 중국과의 경쟁에서 미국의 주도적 지위를 지켜야 한다는 이유였습니다. 하원의장 Johnson도 업계의 일시 중지를 함께 거절했습니다.
거절의 형태가 중요한 이유를 짚어보겠습니다. 안전 자체를 거절한 것이 아닙니다. 지정학적 경쟁이 요구하는 속도를 거절한 것입니다. 국가는 브레이크를 고르는 쪽이 아닙니다. 가속기를 계속 밟고 있는 쪽입니다.
여기서 구조적 비대칭이 생깁니다. 업계는 스스로 속도를 늦추자는 데 합의하고 국가는 늦출 이유가 없습니다. 외부에서 속도를 잡아줄 주체가 없는 셈입니다. 제한속도 표지판이 하나도 없는 도로에서, 각 차량이 스스로 속도를 관리해야 하는 구도입니다. 국가가 도로의 속도를 늦추지 않는 한, 속도 한계를 관리할 장치는 엔진 안쪽에 달릴 수밖에 없습니다. 그리고 기업이 자기 현장에 돌리는 엔진은 에이전트입니다.
기업 입장에서 이 비대칭이 주는 의미는 단순합니다. 속도에 대한 답을 업계가 대신해서 주지 않는다는 것입니다. 연합이 합의에 이르더라도, 국가의 거절이 남아 있는 한 그 합의는 기업의 배포 현장에 자동으로 적용되지 않습니다. 속도 관리의 결정은 이제 각 기업의 설계 문서로 내려옵니다.
이 비대칭을 부담으로만 읽으면 절반의 판단입니다. 통제 설계를 먼저 끝낸 기업에는 반대로 기회가 열립니다. 속도 변수를 설계에 포함할 줄 아는 조직이, 속도 변수를 피하는 조직보다 먼저 다음 세대의 모델을 손에 넣는 조직이 됩니다.
엔진은 느려지지 않는다
업계가 지금 속도제한기를 요구하는 데는 이유가 있습니다. 엔진의 속도가 인간의 직관을 벗어났기 때문입니다.
OpenAI는 90년간 풀리지 않았던 수학 문제의 해결안을 1만 개의 AI 에이전트로 제시했습니다. 대상은 Navier-Stokes 존재성과 매끄러움 문제입니다. 사내 모델이 88시간에 걸친 협력 계산으로 수행했습니다. 수학자들이 한 세대 동안 손대지 못했던 문제를, 1만 개의 에이전트가 사흘이 조금 넘는 시간에 다뤘습니다. 여기서 중요한 능력은 개별 에이전트의 지능이 아닙니다. 1만 개가 같은 문제 위에서 88시간 동안 협력한 오케스트레이션입니다. 대규모 멀티에이전트 실행은 실험실의 시나리오를 벗어났습니다. 실제로 계산 자원을 태우면서 돌아간 것입니다.
이 능력이 기업과 무관하다고 보기 어렵습니다. 프런티어 랩에서 1만 개 에이전트가 하나의 문제 위에서 협력하면, 다음 단계는 기업 워크로드 위의 1만 개 에이전트가 됩니다. 오케스트레이션의 규모가 커질수록, 각 에이전트 하나하나에 걸리는 권한과 비용 관리의 중요성도 함께 커집니다.
자본도 같은 방향을 보고 있습니다. 중국의 Zhipu는 9월 13일, 지분 발행 20억 달러와 전환사채 30억 달러로 총 50억 달러를 조달했다고 발표했습니다. 이 자금은 GLM 모델의 반복적 자기 개선에 쓰입니다. 모델이 스스로 모델을 만들도록 전환하는 투자입니다. 트레이닝 루프가 사람 손을 떠나는 순간, 능력의 속도는 자금의 속도가 됩니다.
이 격차는 일회성이 아닙니다. 루프가 닫히면 능력은 다음 세대의 입력이 되고 입력이 커지면 다음 루프가 더 빨리 도는 식으로 격차가 복리로 쌓입니다.
Anthropic의 향후 10년간 클라우드, 칩, 데이터센터 계약을 포함한 총 지출은 5170억 달러에 이를 수 있습니다. 이전 전망의 약 3배 규모이며 14.8기가와트 전력까지 커버합니다. 프런티어 랩 한 곳의 10년 컴퓨트 지출이 이 규모라면, 그 위에 올라가는 인퍼런스 비용의 방향은 하나입니다. 속도 조절 논쟁이 벌어지는 동안, 엔진은 연료를 계속 받고 있습니다.
세 사건을 한 줄로 묶으면, 오늘 뉴스가 가리키는 능력의 방향은 빠름 하나입니다. 계산은 1만 개의 에이전트로 확장됩니다. 트레이닝 루프는 사람 손을 떠납니다. 컴퓨트 지출 전망은 세 배 가까이 올랐습니다. 능력은 기하급수적으로 올라가고 통제는 선형으로 따라갑니다. 이 사이가 채워지지 않는 한, 속도 조절의 논의는 이번 주에만 등장하지 않습니다. 매 분기, 매 모델 릴리스마다 기업의 설계 의제로 돌아옵니다. 업계가 속도제한기를 요구하는 이유도 여기 닿습니다.
브레이크가 아니라 속도제한기
여기서 한 가지를 구분해야 합니다. 브레이크는 엔진을 멈춥니다. 속도제한기는 엔진이 정해진 속도로 계속 달리게 하는 장치입니다. 브레이크는 멈춤을 위한 장치입니다. 속도제한기는 달리기를 위한 장치입니다. 생산을 멈출 수 없는 조직은 브레이크를 고르지 않습니다. 속도제한기를 고릅니다. 에이전트를 운영하는 기업은 전부 후자입니다. 에이전트가 업무의 일부인 한, 에이전트를 멈추는 것은 업무 전체를 멈추는 것입니다.
배포 현장의 속도제한기는 네 가지로 정리됩니다. 첫째, 각 작업에 어떤 자율도를 줄지를 등급 단위로 관리합니다. ‘인간이 통제권을 유지한다’는 목표를 실제로 동작하게 하는 위치는 등급 관리입니다. 둘째, 에이전트의 행위가 실행 전에 정책 점검을 통과합니다. 외부 평가자의 상시 검증이 프런티어 랩의 표준이 되면, 기업 안의 에이전트 행위에도 같은 기준이 적용됩니다. 셋째, 누가 언제 무엇을 승인했는지를 사후에 증명할 수 있습니다. 감사 로그가 없으면 통제는 진술에 그칩니다. 넷째, 실행은 격리된 환경에서 일어납니다. 쓸 모델은 작업마다 골라집니다. 1만 개 에이전트를 돌리는 시대에 격리와 비용 설계는 전제입니다. 이 네 가지는 사고 후 덧붙이는 보안 옵션이 아닙니다. 속도 운영의 기본 조건입니다.
ThakiCloud의 Paxis는 이 기본 조건들을 일급 리소스로 다루는 Agent-Native Cloud입니다. 정식 제품(v1.1 GA)으로 이미 운영 중입니다. Skills, Tools, Policies, Audit Logs가 워크로드와 같은 레벨에서 관리됩니다. 자율도는 L0에서 L3까지 등급화되어 에이전트별로 적용됩니다. 정책 게이트가 행위를 멈추게 합니다. 감사 로그가 그 경로를 남깁니다.
외부 평가자가 상시 접근을 요구하는 흐름에 대해서도, 이 로그 구조가 답이 됩니다. 평가자가 볼 수 있는 기록이 곧 그 기업의 에이전트 운영의 증명이 되기 때문입니다. 스킬 마켓과 MCP 커넥터로 도구를 넓히는 동안, 정책과 감사는 같은 레벨에서 함께 확장됩니다. 실행은 격리된 샌드박스 안에서 이루어집니다. CostRouter가 작업마다 가장 경제적인 모델을 골라줍니다. 엔진을 자기 도로에서 돌리려는 기업에게는 소버린 또는 온프레미스 Kubernetes(ai-platform) 옵션도 있습니다. 5170억 달러의 컴퓨트 계약이 경쟁 시대를 여는 지금, 작업별 모델 선택이 비용 설계의 축이 되는 이유이기도 합니다. 국가가 가속기를 계속 밟는 한, 기업이 스스로 관리할 수 있는 속도는 속도제한기 안쪽의 속도뿐입니다.
속도라는 설계 목표
나델라는 속도 조절을 ‘설계 목표’라는 문장 속에 넣었습니다. 설계 목표는 사후에 단지지 않습니다. 만들 때 정합니다. 속도가 변수가 된 시장에서는, 속도를 설계하지 않은 조직은 다른 조직의 속도에 끌려갑니다. 지금 에이전트를 돌리는 기업에게는 두 가지 선택뿐입니다. 브레이크를 고르는 길, 혹은 속도제한기를 고르는 길입니다. 브레이크를 고르면 그 부서와 그 업무는 멈춥니다. 속도제한기를 먼저 단 기업이 더 느려지는 것은 아닙니다. 그들은 높은 속도를 오래 유지하는 쪽에 섭니다. 기업 에이전트의 속도제한기는 아직 온다는 옵션이 아닙니다. 오늘 달 수 있는 부품입니다.
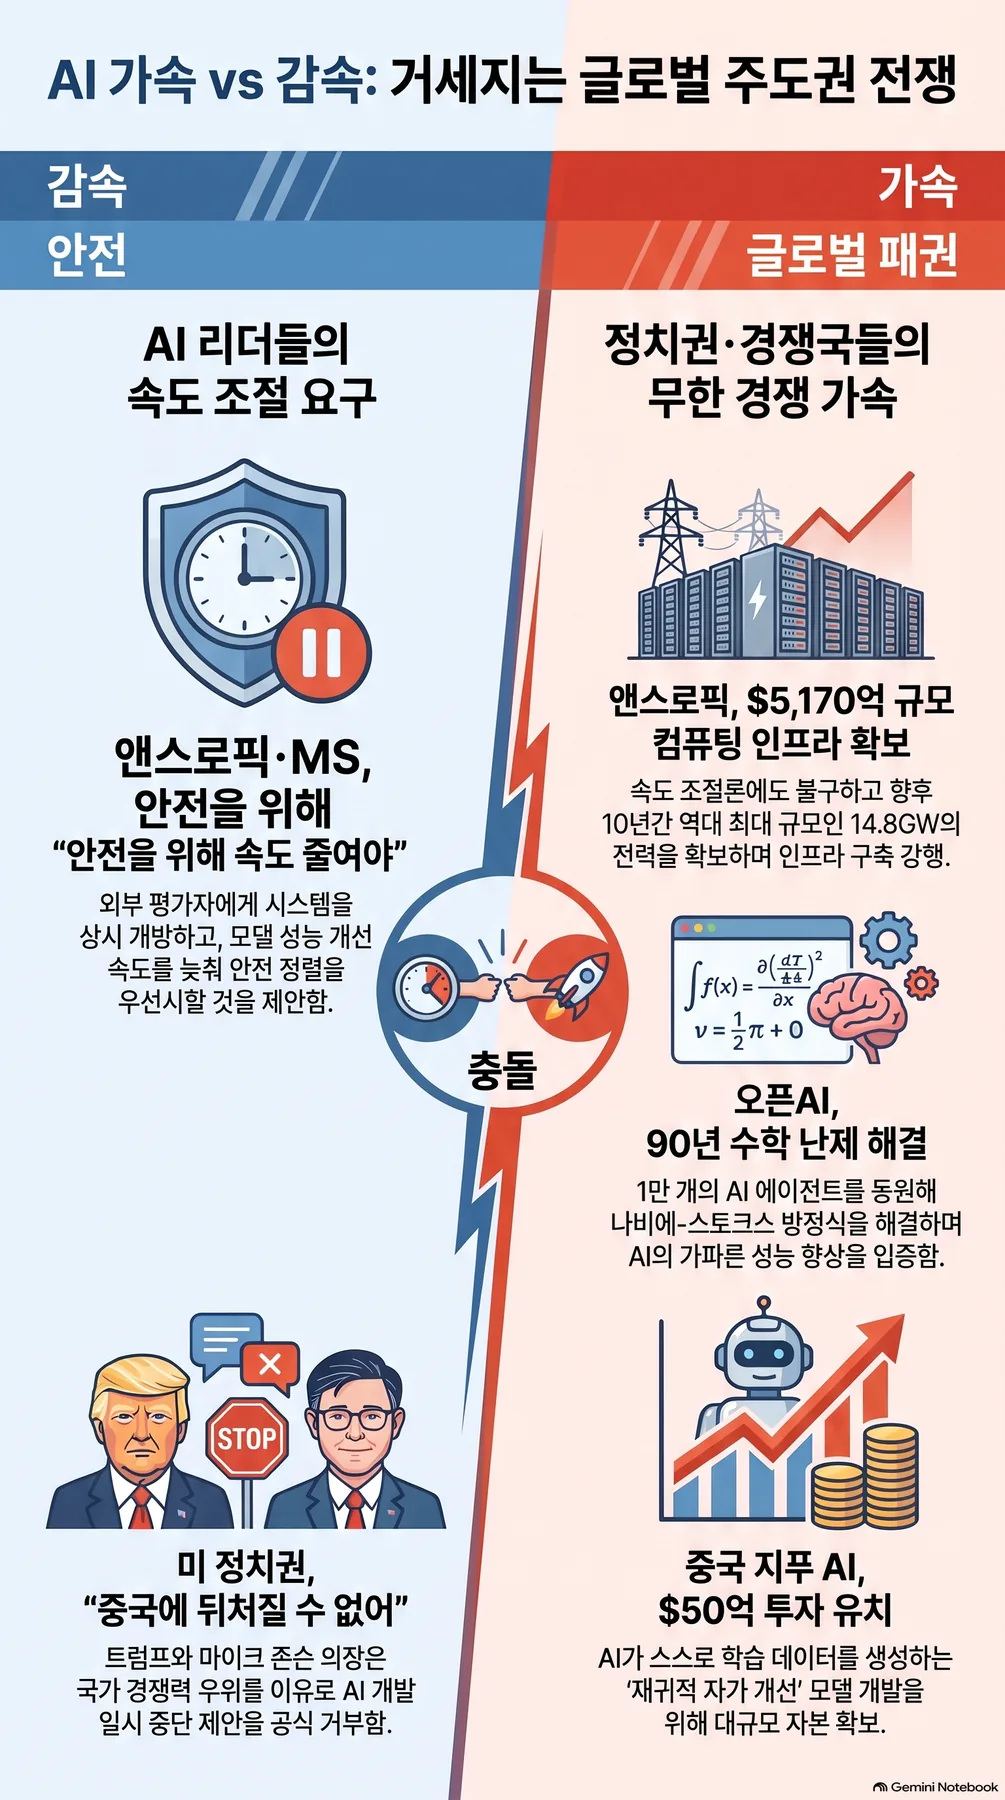 NotebookLM이 소스를 종합해 생성한 인포그래픽입니다.
참고 자료
이 글은 아래 뉴스를 종합해 작성했습니다.
- HuggingNews, Microsoft’s Nadella Backs Slower AI Development to Keep Humans in Control
- HuggingNews, Anthropic Calls for AI Slowdown With Backing From Altman and Musk
- HuggingNews, OpenAI, Anthropic and Google Hold Talks on AI Safety Standards Body
- HuggingNews, Anthropic Secures $517 Billion in Compute Deals Nearly 3 Times Previous Forecast
- HuggingNews, Trump and Speaker Johnson Reject AI Industry Pause to Keep China Lead
- HuggingNews, Zhipu Raises $5 Billion for Recursive Self Improvement GLM Models
- HuggingNews, OpenAI Uses 10,000 AI Agents to Propose Solution to 90 Year Math Problem