Sovereign AI Cloud란? 데이터 위치보다 중요한 통제 범위
“Sovereign AI”라는 표현이 빠르게 늘고 있습니다.
국가 차원의 AI 인프라, 공공·금융·의료처럼 민감한 산업, 지역별 데이터 규제, 글로벌 Cloud 의존성 문제가 함께 커지면서 AI를 “어디에서” 운영하느냐뿐 아니라 “누가 통제하느냐”가 중요한 질문이 되고 있습니다.
그런데 Sovereign AI를 단순히:
“데이터를 국내에 저장하는 AI”
라고 이해하면 핵심을 놓치기 쉽습니다.
Data Residency는 매우 중요한 요소입니다.
하지만 AI System은 Data만으로 구성되지 않습니다.
관리자 권한, Encryption Key, Compute Infrastructure, Model, AI Artifact, Software Update, Operations, Legal Jurisdiction과 외부 Provider Dependency까지 함께 움직입니다.
따라서 Sovereign AI의 더 정확한 질문은:
“이 AI Workload에서 어떤 통제권을 우리 조직 또는 정해진 관할 안에 유지해야 하는가?”
입니다.
데이터 위치만으로는 충분하지 않습니다
예를 들어 모든 데이터가 한국 데이터센터에 저장되어 있다고 가정해 보겠습니다.
하지만 다음 질문에 답할 수 없다면 Sovereignty 요구는 여전히 남아 있을 수 있습니다.
- 해외 운영자가 관리자 권한으로 접근할 수 있는가?
- 암호화 키는 누가 보유하고 통제하는가?
- Backup은 어디에 저장되는가?
- Model Weight와 Vector Database는 어디에 있는가?
- Control Plane은 어느 국가 / Provider에서 운영되는가?
- 장애 발생 시 누가 System을 운영하고 복구하는가?
- 외부 Provider가 서비스를 중단하면 Workload를 계속 운영할 수 있는가?
- 어떤 법적 관할과 계약 조건이 적용되는가?
즉:
Data Residency는 “어디에 있는가”를 설명하고, Sovereignty는 “누가 어떤 권한으로 통제하는가”까지 묻습니다.
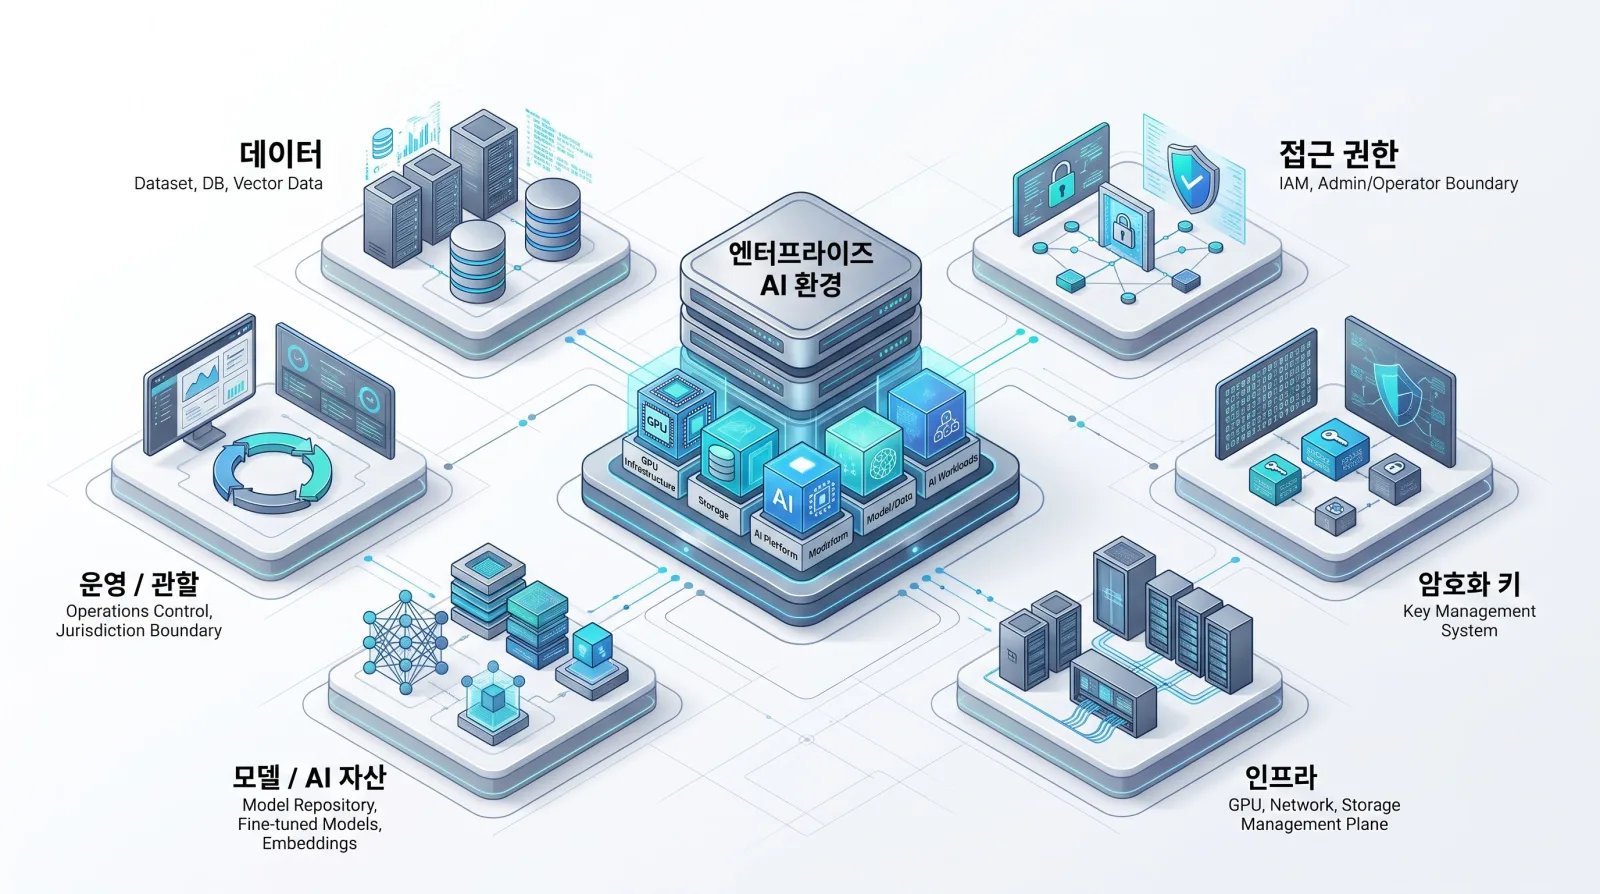
Sovereign AI의 통제 범위를 6개 영역으로 보면
조직마다 필요한 수준은 다르지만 실무적으로는 다음 영역을 함께 보는 것이 유용합니다.
1. Data Control
가장 먼저 떠올리는 영역입니다.
- Training / Fine-tuning Data
- Prompt / Response
- Embedding
- Vector Index
- Log
- Backup
같은 데이터가 어디에 저장되고 처리되는지 확인합니다.
중요한 것은 위치뿐 아니라 복제, Backup, Retention, Export까지 포함한 전체 Lifecycle입니다.
2. Identity / Administrative Access
누가 System에 접근할 수 있는가를 봅니다.
일반 사용자의 IAM뿐 아니라:
- Cloud Operator
- Platform Administrator
- Support Engineer
- Vendor Personnel
의 권한도 중요할 수 있습니다.
Data가 국내에 있어도 해외 관리자에게 광범위한 접근 권한이 있다면 일부 Sovereignty Requirement와 충돌할 수 있습니다.
3. Key / Encryption Control
Encryption을 사용한다는 사실만으로 통제가 완성되는 것은 아닙니다.
- Key를 누가 생성하는가?
- 어디에 저장되는가?
- 누가 Rotation하는가?
- Provider가 Key에 접근할 수 있는가?
- Customer-managed Key가 필요한가?
를 확인해야 합니다.
4. Infrastructure Control
Compute, Network, Storage가 어느 시설과 관할에 위치하는지 봅니다.
어떤 Workload는 국내 Infrastructure만으로 충분할 수 있고, 더 높은 통제 수준이 필요한 경우 Hardware / Control Plane / Management Network까지 별도 요구가 생길 수 있습니다.
5. Model / AI Artifact Control
AI에서는 Data 외에도 Model 자체가 중요한 자산입니다.
- Model Weight
- Fine-tuned Model
- Adapter
- Prompt Template
- Agent Skill
- Vector Index
- Evaluation Artifact
같은 자산이 어디에 저장되고 누가 변경할 수 있는지도 중요합니다.
Model Lineage와 Version Control 역시 Governance의 일부가 될 수 있습니다.
6. Operations / Jurisdiction
마지막은 실제 운영과 법적 책임입니다.
- 누가 운영하는가?
- 어떤 회사가 계약 주체인가?
- 어떤 법률이 적용되는가?
- 어떤 Support Organization이 접근 가능한가?
- 장애 시 누가 결정권을 갖는가?
- Provider 변경이나 Exit가 가능한가?
를 봅니다.
이 영역 때문에 Sovereignty는 단순한 기술 기능보다 Operating Model에 더 가까운 문제가 됩니다.
Sovereign AI와 Data Residency는 무엇이 다른가?
Data Residency는 Sovereign AI의 중요한 구성 요소입니다.
하지만 두 개념을 같은 것으로 보면 안 됩니다.
Data Residency
- Data가 어느 Region / Country에 저장되는가?
Sovereign Control
- Data뿐 아니라 Access, Keys, Infrastructure, Models, Operations와 Jurisdiction을 누가 통제하는가?
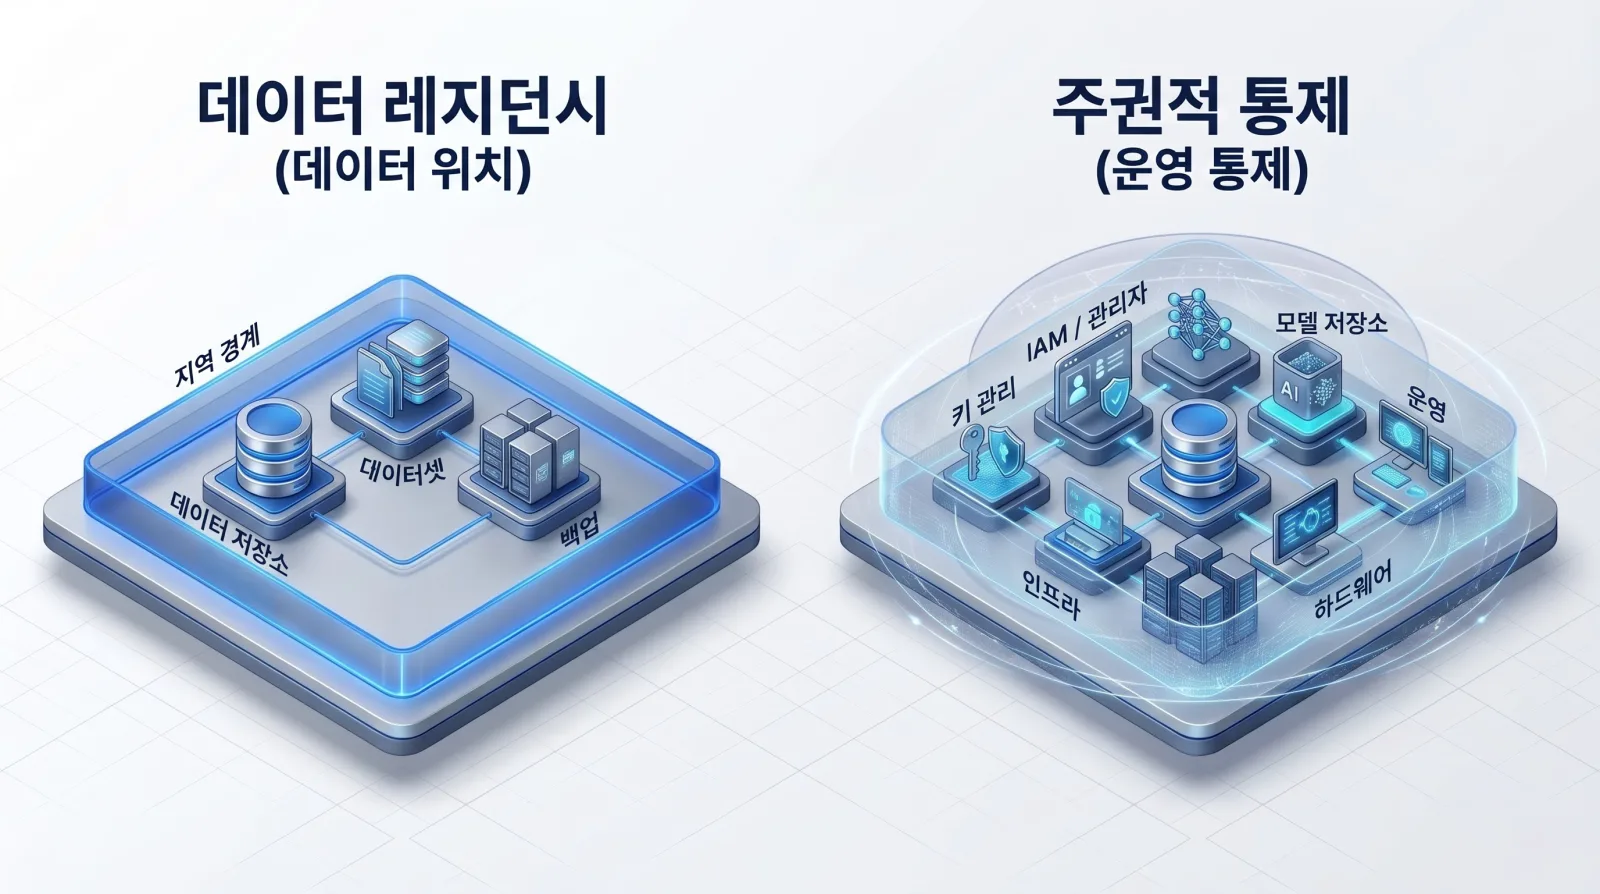
Data Residency는 잘못된 개념이 아니라 더 넓은 Sovereignty Architecture 안에 포함되는 하나의 Control입니다.
Sovereign Cloud와 Sovereign AI도 같은 말일까요?
서로 겹치지만 완전히 같지는 않습니다.
Sovereign Cloud는 일반적인 Cloud Infrastructure와 Data, Operations, Jurisdiction에 대한 통제를 중심으로 논의됩니다.
Sovereign AI는 여기에 AI-specific Asset와 Lifecycle이 추가됩니다.
예를 들어:
- Training Data
- Model Weight
- Prompt / Response
- Embedding
- Model Registry
- Fine-tuning Artifact
- Agent / Tool Access
- AI Evaluation
같은 영역입니다.
AI는 Data를 읽는 것에서 끝나지 않고 새로운 Model / Artifact / Output을 계속 생성하기 때문에 통제 범위가 더 넓어질 수 있습니다.
반드시 On-Prem이어야 할까요?
아닙니다.
On-Prem은 Deployment Location을 설명합니다.
Private AI Cloud는 특정 Organization을 위한 Operating Model을 설명합니다.
Sovereign AI는 필요한 Control Scope를 설명합니다.
세 개념은 겹칠 수 있지만 같은 말은 아닙니다.
예를 들어:
- On-Prem + Sovereign AI
- Hosted Private Cloud + Sovereign Controls
- Regional Public / Sovereign Cloud Service
같은 다양한 구조가 가능합니다.
어떤 구조가 적합한지는 Workload와 통제 요구에 따라 달라집니다.
“국산 기술만 사용해야 Sovereign AI”일까요?
항상 그렇다고 말하기 어렵습니다.
국가 또는 사업의 목표에 따라 Domestic Technology, Local Ownership, Local Operations를 중요하게 볼 수 있습니다.
하지만 Sovereignty Requirement는 조직·국가·Workload마다 다릅니다.
어떤 경우에는 Data와 Admin Access의 국내 통제가 핵심일 수 있고, 다른 경우에는 Hardware Supply Chain이나 Model까지 더 높은 수준의 독립성이 필요할 수 있습니다.
따라서 “Sovereign AI = 100% 국내 기술”이라는 하나의 공식으로 단순화하는 것보다:
어떤 Dependency를 허용하고 어떤 Control을 반드시 유지해야 하는가?
를 정의하는 것이 더 실무적입니다.
Workload마다 필요한 Sovereignty Level은 다를 수 있습니다
모든 AI Workload를 가장 높은 통제 환경에 넣는 것은 비용과 운영 복잡성을 키울 수 있습니다.
예를 들어:
낮은 민감도
공개 Data 기반의 일반 업무 AI는 Global Cloud를 활용할 수 있습니다.
중간 민감도
기업 내부 문서나 IP를 사용하는 RAG / Agent Workload는 Data, Identity, Logging과 Model Endpoint에 더 높은 통제가 필요할 수 있습니다.
높은 민감도
국가안보, Critical Infrastructure, 고규제 Data를 다루는 Workload는 Infrastructure, Admin, Key, Network와 Operations까지 더 강한 Sovereignty Boundary가 필요할 수 있습니다.
즉 Sovereignty는 “Yes / No”보다 Control Level로 보는 편이 현실적입니다.
왜 NeoCloud와 Sovereignty가 함께 이야기될까요?
2026년 NeoCloud 시장 논의에서도 Sovereignty는 중요한 차별화 요소로 등장하고 있습니다.
전통적인 Global Hyperscaler와 달리 일부 NeoCloud는:
- 특정 국가 / 지역에 집중한 Infrastructure
- AI Workload에 특화된 Compute
- Local Operation
- Flexible Deployment
- Sovereign Control
을 차별화 포인트로 제시합니다.
Gartner도 2026년 NeoCloud 시장을 설명하면서 Sovereign Cloud Capability와 지역별 AI Infrastructure 수요를 주요 요인으로 언급했습니다.
하지만 모든 NeoCloud가 Sovereign Cloud인 것은 아닙니다.
NeoCloud는 AI-specialized Cloud Category이고, Sovereignty는 그 서비스가 제공할 수 있는 Control Model 중 하나입니다.
Resilience와 Exit도 Sovereignty의 일부입니다
Sovereignty를 “현재 누가 접근할 수 있는가?”만으로 보면 부족할 수 있습니다.
장기적으로는:
- Provider가 서비스를 중단하면?
- 가격이나 계약 조건이 크게 바뀌면?
- 특정 국가의 법률이나 제재가 바뀌면?
- Model / Data를 다른 환경으로 이전할 수 있는가?
- Backup과 Key를 독립적으로 유지할 수 있는가?
도 중요한 질문입니다.
즉 Sovereignty는 Control뿐 아니라 Operational Resilience와 Dependency Management 문제이기도 합니다.
Thaki Cloud는 이 문제를 어떻게 볼까요?
Thaki Cloud는 NeoCloud와 Private / On-Prem AI 두 방향을 모두 다룹니다.
Thaki NeoCloud OS의 Canonical Architecture는:
Customer Infrastructure → Thaki NeoCloud OS → Customer NeoCloud Service
입니다.
Infrastructure Owner가 자신의 GPU / AI Infrastructure와 자체 브랜드 Cloud Service를 운영할 수 있도록 하는 구조는 Operator가 Service Catalog, Tenancy, Provisioning, Metering과 Lifecycle을 직접 설계할 수 있는 기반을 제공합니다.
다만 특정 Sovereign AI Requirement 충족 여부는:
- Infrastructure Location
- Operator
- IAM
- Key Management
- Data Handling
- Network
- Legal / Contractual Structure
등 실제 배포 환경에 따라 별도로 검증해야 합니다.
정리하면
Sovereign AI의 핵심은 “Data가 국내에 있는가?”라는 한 가지 질문이 아닙니다.
더 중요한 질문은:
Data, Access, Keys, Infrastructure, Models, Operations와 Jurisdiction 중 무엇을 어디까지 직접 통제해야 하는가?
입니다.
Data Residency는 중요한 시작점입니다.
하지만 실제 Sovereign AI Architecture는 Workload별 Risk와 Dependency를 기준으로 통제 범위를 설계해야 합니다.
FAQ
국내 데이터센터에서 AI를 운영하면 Sovereign AI인가요?
반드시 그렇지는 않습니다. Data Location 외에도 Administrator Access, Key, Operations, Legal Jurisdiction과 Dependency를 확인해야 할 수 있습니다.
Sovereign AI는 반드시 On-Prem이어야 하나요?
아닙니다. On-Prem은 Deployment Location이고 Sovereignty는 Control Requirement입니다.
Sovereign Cloud와 Sovereign AI는 같은가요?
겹치는 영역이 많지만 AI에서는 Model, Training Data, Embedding, Agent와 AI Artifact Governance가 추가됩니다.
Public Cloud에서는 Sovereign AI가 불가능한가요?
그렇지 않습니다. Region, Operator, Key, Admin Access와 Contractual Control에 따라 일부 또는 높은 수준의 Sovereign Requirement를 충족하는 Hosted / Public 구조도 가능합니다.
모든 Workload에 같은 Sovereignty Level이 필요한가요?
아닙니다. Data Sensitivity, Regulation, Business Risk와 Dependency에 따라 필요한 통제 수준이 달라질 수 있습니다.
Sovereign AI Architecture를 검토하고 계신가요?
Data Location만이 아니라 Access, Infrastructure, AI Platform과 Operations까지 어떤 통제 범위를 유지해야 하는지 정의하고 있다면 Thaki Cloud와 Workload 기준 Architecture를 함께 검토해 보세요.
문의하기참고 자료
관련 아티클
- GPU Cloud란 무엇인가? 개념, 작동 방식, GPUaaS와의 차이GPU Cloud는 데이터센터의 GPU를 네트워크를 통해 필요할 때 사용하는 클라우드 컴퓨팅 방식입니다. GPUaaS와의 차이, 작동 방식, Bare Metal·Virtual GPU 유형, 활용 사례와 운영 구조를 설명합니다.
- AI Factory란 무엇인가? AI 데이터센터와 무엇이 다른가?AI Factory는 AI 워크로드를 반복적으로 개발·학습·배포·운영하기 위한 통합 인프라와 운영 환경입니다. AI 데이터센터와의 차이, 핵심 구성 요소, AI Lifecycle, GPU Cloud와의 관계를 설명합니다.
- GPUaaS란 무엇인가? GPU as a Service의 구조와 핵심 기능GPUaaS는 GPU 연산 자원을 직접 구매하지 않고 서비스 형태로 사용하는 방식입니다. GPU Cloud와의 차이, 작동 방식, Bare Metal·Virtual GPU 제공 형태, 운영 기능과 선택 기준을 설명합니다.
- Private AI Cloud란 무엇인가?Private AI Cloud는 단일 조직 전용의 Private Cloud 운영 모델에 GPU·AI 플랫폼·데이터·보안·거버넌스를 결합한 AI 환경입니다. Public AI Cloud, On-Prem AI, Sovereign AI, Air-Gapped AI와의 차이와 구축 고려사항을 설명합니다.
- GPU 서버가 있다고 GPU Cloud가 되는 것은 아닙니다GPU 서버를 보유하거나 호스팅한다고 자동으로 GPU Cloud가 되는 것은 아닙니다. GPU Hosting과 GPU Cloud의 차이, Self-Service·Provisioning·Scheduling·Metering 등 Cloud 운영에 필요한 핵심 기능을 설명합니다.
- NeoCloud란 무엇인가? AI 시대의 GPU 중심 클라우드NeoCloud는 GPU와 AI Workload에 특화된 Cloud Infrastructure Provider를 설명할 때 사용되는 산업 용어입니다. 기존 Hyperscaler, GPU Cloud, GPUaaS와의 관계와 Thaki Cloud의 NeoCloud Enablement 관점을 설명합니다.
- AI Factory의 다음 단계는 Cloud Service입니다AI Factory를 구축하는 것과 고객이 실제로 사용할 수 있는 Cloud Service를 운영하는 것은 다릅니다. Provisioning, Multi-Tenancy, GPU Scheduling, Metering, Billing, SLA 등 서비스화에 필요한 운영 계층을 설명합니다.
- AI 인프라를 Cloud Business로 전환한다는 것은 무엇인가?GPU와 AI 인프라를 보유하는 것과 실제 Cloud Business를 운영하는 것은 다릅니다. Infrastructure → Product → On-demand Cloud Service 전환 과정과 Service Catalog, Provisioning, Metering, Billing, SLA 등 사업화에 필요한 운영 구조를 설명합니다.
- Bare Metal GPU란? 가상화 GPU와의 차이와 활용 방식Bare Metal GPU의 개념과 GPU VM, vGPU, GPU Passthrough의 차이를 알아보세요. 전용성, 성능 일관성, 유연성, 자원 효율, Provisioning 관점에서 어떤 방식이 적합한지 설명합니다.
- Private AI Cloud와 Public AI Cloud의 차이Private AI Cloud와 Public AI Cloud를 전용성, 통제 범위, 확장성, Managed Service, 운영 책임, 비용 구조 관점에서 비교합니다. 어떤 AI Workload에 각각 적합한지 알아보세요.
- GPU Scheduling이란? AI Cloud에서 GPU 자원을 배분하는 방법GPU Scheduling의 개념과 Queue, Priority, Quota, GPU Type, Topology, Multi-GPU Job, Resource Fragmentation을 알아보세요. GPU Cloud에서 Scheduling과 Provisioning이 어떻게 다른지도 설명합니다.
- AI Factory 구축 이후에 필요한 운영 플랫폼은 무엇인가?AI Factory 구축 이후 실제 운영 단계에서 필요한 Provisioning, GPU Scheduling, 사용자·Policy 관리, Observability, Capacity Management, Metering과 Lifecycle Automation을 알아보세요.
- On-Prem AI란? 기업이 자체 환경에서 AI를 운영하는 이유On-Prem AI의 개념과 Private AI Cloud와의 차이, 기업이 데이터·모델·네트워크·지연시간·운영 통제를 이유로 자체 환경에서 AI를 운영하는 경우와 Trade-off를 알아보세요.
- GPU Multi-Tenancy란? 여러 고객이 GPU 인프라를 안전하게 사용하는 구조GPU Multi-Tenancy의 개념과 Tenant Isolation, Dedicated GPU, vGPU, MIG, Kubernetes Namespace, Quota, Scheduling, Network·Storage 분리와 Usage 관리 구조를 알아보세요.
- GPU Provisioning이란? 주문에서 사용 가능 상태까지의 자동화GPU Provisioning의 개념과 GPU 요청 이후 Compute, Network, Storage, Image, Runtime, Access를 준비해 실제 사용 가능한 환경으로 만드는 자동화 과정을 알아보세요.
- AI Factory를 Multi-Customer Cloud Service로 전환하려면AI Factory를 여러 고객이 사용하는 Cloud Service로 전환할 때 필요한 Service Catalog, Multi-Tenancy, Provisioning, Scheduling, Metering, Billing, SLA와 Lifecycle을 알아보세요.
- GPU 클라우드 사업화 준비도 체크리스트: 무엇을 점검해야 할까?GPU 서버를 보유했다고 바로 GPU 클라우드 서비스를 판매할 수 있는 것은 아닙니다. 서비스 상품화, 멀티테넌시, 프로비저닝, 사용량 측정, 과금, SLA와 자원 라이프사이클을 12개 실무 항목으로 점검합니다.
- GPU 클라우드 수익성 분석: 가동률보다 중요한 것은 무엇일까?GPU 사용률과 과금 가능 시간은 같은 지표가 아닙니다. 가상의 32-GPU 계산 예시를 통해 판매 가능 용량, 과금 가능 GPU 시간, 실현 단가, 고정비·변동비와 손익분기점을 설명합니다.
- GPU 클라우드 직접 구축 vs. 통합 운영 플랫폼: 무엇이 더 합리적일까?OpenStack, Kubernetes, Prometheus 같은 오픈소스로 GPU 클라우드를 구축할 수 있습니다. 직접 통합과 운영 플랫폼 도입을 연동, 실패 처리, 과금, 확장성과 3–5년 총소유비용 관점에서 비교합니다.
- Self-Service Cloud란? 고객이 직접 주문하고 사용하는 클라우드 서비스셀프서비스 클라우드는 단순한 포털이 아닙니다. 서비스 카탈로그, IAM, 정책·할당량, 가용 용량, 프로비저닝, 사용량 측정과 자원 회수가 어떻게 연결되어야 하는지 설명합니다.
- On-demand GPU Service란? 필요한 GPU를 필요할 때 제공받는 방식온디맨드 GPU는 Shared GPU나 Spot GPU와 같은 말이 아닙니다. 요청, 가용 용량, 프로비저닝, 사용량 측정과 반환이 어떻게 연결되는지, 전용 베어메탈도 온디맨드 방식으로 제공할 수 있는지 설명합니다.
- Cloud Service Catalog란? GPU 인프라를 서비스 상품으로 만드는 첫 단계클라우드 서비스 카탈로그는 GPU 재고 목록이나 가격표가 아닙니다. GPU·네트워크·스토리지를 고객이 주문할 수 있는 상품으로 정의하고 정책, 프로비저닝, 과금과 연결하는 구조를 설명합니다.
- 데이터센터가 GPU Hosting에서 GPU Cloud로 전환하려면GPU Hosting에서 GPU Cloud로의 전환은 하드웨어 교체보다 운영 모델 변화에 가깝습니다. 서비스 카탈로그, 셀프서비스, 프로비저닝, 고객 분리, 사용량 측정·과금과 자원 회수를 어떻게 추가해야 하는지 설명합니다.
- 통신사가 보유 GPU 인프라로 자체 AI Cloud Service를 만드는 방법통신사가 보유한 데이터센터·네트워크·GPU 인프라를 고객용 AI Cloud Service로 확장하려면 무엇이 필요할까요? 서비스 상품화, 셀프서비스, 프로비저닝, 고객 분리, 사용량 측정과 운영 구조를 설명합니다.
- Air-Gapped AI란? 망분리 환경에서 AI를 운영하는 방식Air-Gapped AI는 단순한 사설망이나 방화벽 환경과 다릅니다. 외부 자동 연결이 없는 환경에서 모델, 데이터, 패키지, 업데이트, 관측과 AI 운영을 어떻게 구성해야 하는지 설명합니다.
- 기업용 AI 인프라 구축 체크리스트: GPU부터 거버넌스까지기업용 AI 인프라는 GPU 구매만으로 완성되지 않습니다. Workload와 Data부터 GPU·Network·Storage, AI Platform, Security·Governance, Operations, Capacity와 Cost까지 12개 실무 항목으로 점검합니다.