Self-Service Cloud란? 고객이 직접 주문하고 사용하는 클라우드 서비스
클라우드 서비스에 “셀프서비스”라는 표현이 붙으면 보통 고객 포털을 먼저 떠올립니다.
고객이 로그인해서 GPU나 VM을 선택하고, 버튼을 눌러 요청하는 화면입니다.
하지만 화면에서 주문 버튼을 누를 수 있다고 해서 곧바로 셀프서비스 클라우드가 되는 것은 아닙니다.
고객이 요청한 뒤 운영팀이 티켓을 확인하고, 남아 있는 서버를 수동으로 찾고, 네트워크를 설정하고, 계정을 만들고, 완료되면 메일로 알려주는 구조라면 고객 화면은 셀프서비스처럼 보여도 실제 운영은 수동일 수 있습니다.
셀프서비스 클라우드의 핵심은 포털 자체가 아니라:
고객의 요청이 정책, 가용 용량, 프로비저닝, 사용 상태와 자원 회수까지 하나의 운영 흐름으로 연결되는가?
입니다.
NIST는 클라우드 컴퓨팅의 핵심 특성 가운데 하나로 On-demand Self-Service를 제시합니다. 사용자가 필요할 때 서버 시간이나 스토리지 같은 컴퓨팅 기능을 서비스 제공자와 매번 사람이 직접 상호작용하지 않고 스스로 제공받을 수 있어야 한다는 개념입니다.
GPU 클라우드에서도 같은 질문이 중요합니다.
GPU를 보유하고 있는 것과 고객이 스스로 GPU 서비스를 주문하고 사용할 수 있는 것은 서로 다른 문제입니다.
셀프서비스는 포털이 아닙니다
고객이 포털에서 “8-GPU 서버 1대, 7일 사용”을 선택했다고 가정해 보겠습니다.
그 다음에는 실제로 많은 일이 일어나야 합니다.
- 이 고객이 해당 상품을 주문할 권한이 있는지 확인
- 조직별 정책과 할당량 확인
- 실제로 사용 가능한 GPU 서버가 있는지 확인
- 필요한 자원을 예약
- 서버, 네트워크, 스토리지 준비
- OS / 이미지 / 런타임 구성
- 인증 정보와 접근 권한 생성
- 고객에게 사용 가능한 상태 표시
- 사용 기록 수집
- 사용 종료 후 자원 정리와 회수
즉 셀프서비스는 고객 화면 하나가 아니라 여러 운영 기능이 연결된 결과입니다.
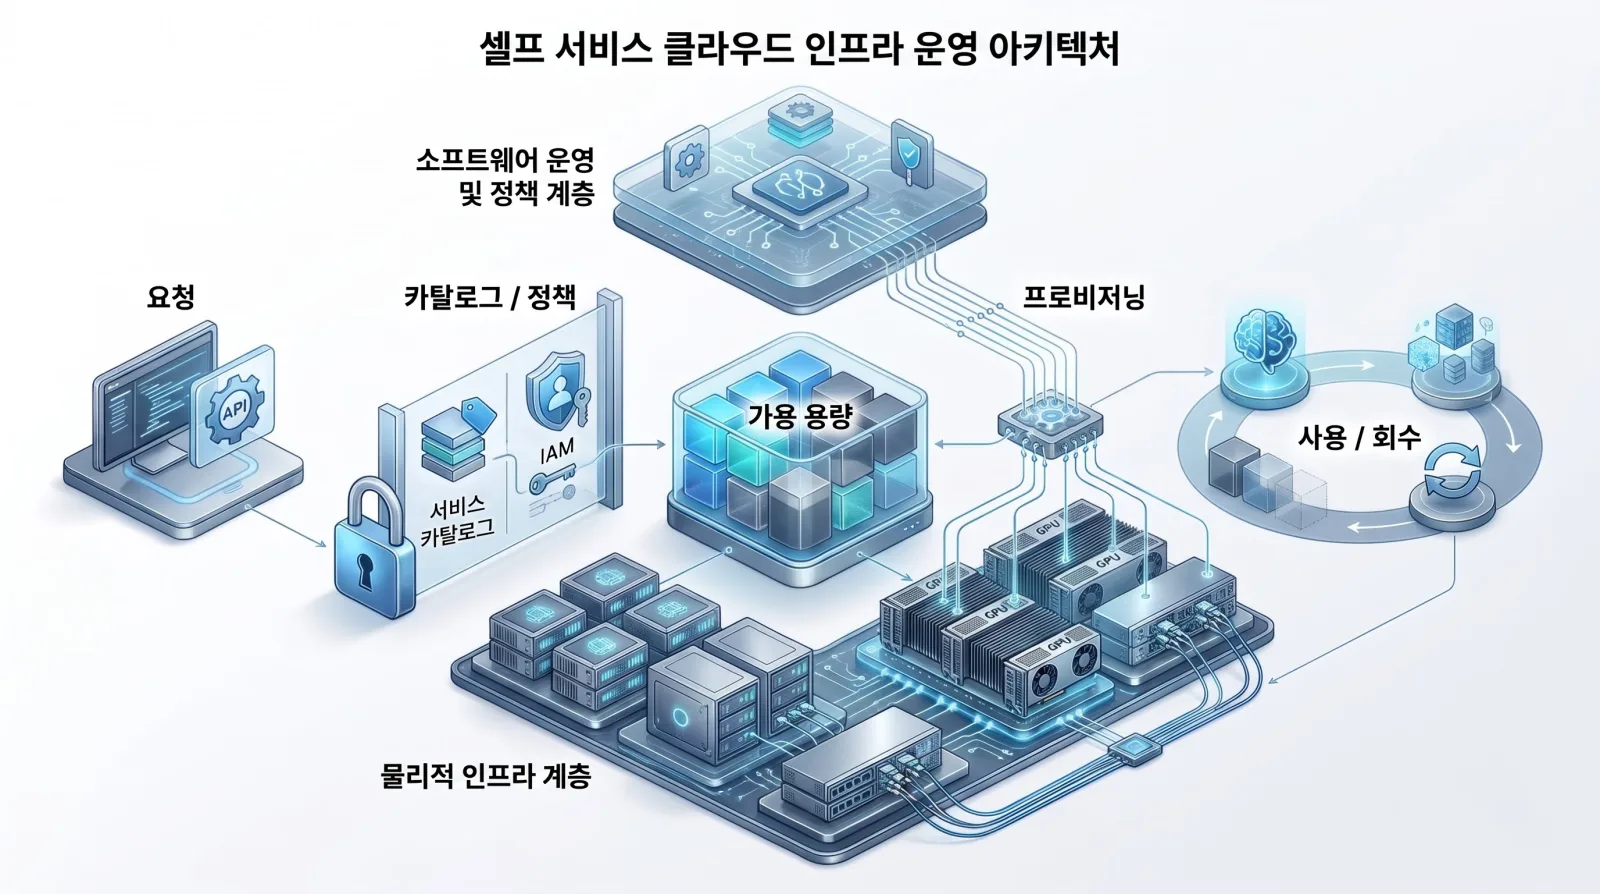
이 연결이 없다면 포털은 단지 새로운 주문 접수 창구에 그칠 수 있습니다.
셀프서비스를 구성하는 핵심 요소
1. 서비스 카탈로그
고객은 무엇을 주문할 수 있는지 알아야 합니다.
예를 들어:
- 전용 베어메탈 GPU 서버
- GPU VM
- 특정 GPU 수량의 워크로드 환경
- 스토리지 / 네트워크 옵션
같은 상품이 서비스 단위로 정의되어야 합니다.
단순한 장비 목록이 아니라 고객이 실제로 선택할 수 있는 상품이어야 합니다.
2. 고객 / 조직 / IAM
누가 어떤 서비스를 요청할 수 있는지 결정해야 합니다.
같은 회사 안에서도 관리자, 개발자, 운영 담당자가 서로 다른 권한을 가질 수 있습니다.
여러 고객을 운영한다면 고객 조직 간 자원, 인증 정보, 네트워크와 데이터 경계도 분리해야 합니다.
3. 정책과 할당량
셀프서비스는 “마음대로 무제한 사용”을 뜻하지 않습니다.
예를 들어:
- 조직 A는 GPU 8개까지
- 특정 상품은 승인된 고객만
- 특정 네트워크 옵션은 특정 계약에서만
- 예약 기간은 최대 30일
처럼 정책을 적용할 수 있습니다.
Kubernetes의 ResourceQuota처럼 기술 계층에서도 조직이나 Namespace별 자원 사용을 제한하는 기능이 존재합니다.
즉 셀프서비스는 통제를 없애는 것이 아니라:
사전에 정의한 통제를 자동으로 적용하는 방식
에 가깝습니다.
4. 가용 용량 확인
서비스 카탈로그에 상품이 있다고 해서 실제 자원이 항상 있는 것은 아닙니다.
GPU는 모델, 서버 구성, 위치, 네트워크와 스토리지 조건에 따라 실제 제공 가능 여부가 달라질 수 있습니다.
따라서 주문 시점에는 “상품이 존재하는가?”뿐 아니라 “지금 제공 가능한가?”를 확인해야 합니다.
5. 프로비저닝
주문이 승인되면 실제 인프라가 고객이 사용할 수 있는 상태로 바뀌어야 합니다.
베어메탈이라면 서버 할당, 이미지 배포, 네트워크 연결, 접근 권한 생성 같은 작업이 필요할 수 있습니다.
VM이나 컨테이너 환경이라면 필요한 컴퓨팅, 네트워크, 스토리지와 런타임이 준비되어야 합니다.
OpenStack Ironic처럼 물리 서버를 API 기반으로 프로비저닝하는 기술도 존재합니다.
6. 서비스 상태
고객은 지금 서비스가 어느 단계인지 알아야 합니다.
예:
- 주문됨
- 확인 중
- 프로비저닝 중
- 사용 가능
- 사용 중
- 종료 중
- 완료
- 실패 / 재시도 중
상태가 실제 인프라 상태와 맞아야 합니다.
그렇지 않으면 고객 화면은 “사용 가능”인데 실제 서버는 준비되지 않았거나, 반대로 서버는 할당됐지만 고객은 접근하지 못하는 문제가 생길 수 있습니다.
7. 사용량 측정과 과금
셀프서비스 구조에서는 누가 어떤 자원을 언제 사용했는지 일관되게 기록할 필요가 있습니다.
기술 모니터링 데이터와 과금 가능 사용 기록은 같지 않을 수 있습니다.
예약형 전용 GPU라면 실제 GPU 사용률이 낮아도 예약 기간 전체가 과금 대상일 수 있습니다.
따라서 서비스 상태, 자원 할당 기록, 계약 조건과 사용량 측정이 연결되어야 합니다.
8. 종료와 자원 회수
고객이 서비스 사용을 끝내면 자원은 다시 가용 상태로 돌아와야 합니다.
인증 정보 회수, 네트워크 정리, 데이터 처리, 서버 초기화, 상태 확인 같은 작업이 필요할 수 있습니다.
이 단계가 반복 가능해야 다음 고객에게 같은 자원을 다시 제공할 수 있습니다.
포털만 있다고 셀프서비스가 되는 것은 아닙니다
다음 두 환경을 비교해 보겠습니다.
환경 A — 포털 + 수동 운영
고객은 웹 화면에서 GPU 서버를 요청합니다.
하지만 뒤에서는:
- 운영팀이 주문 티켓 확인
- 엑셀이나 별도 시스템에서 재고 확인
- 수동 서버 할당
- 네트워크팀에 별도 요청
- 계정 수동 생성
- 고객에게 메일로 완료 통보
가 이루어집니다.
이 구조도 충분히 유효한 운영 방식일 수 있습니다.
다만 고객 화면만 자동화됐을 뿐 전체 서비스 제공 과정은 셀프서비스형 클라우드와 다릅니다.
환경 B — End-to-End 셀프서비스
고객 요청이:
- 권한 확인
- 정책 / 할당량
- 가용 용량
- 자원 예약
- 프로비저닝
- 서비스 상태
- 사용 기록
- 종료 / 회수
와 연결됩니다.
운영자는 모든 요청을 직접 처리하는 대신 정책, 예외, 용량과 운영 품질을 관리합니다.
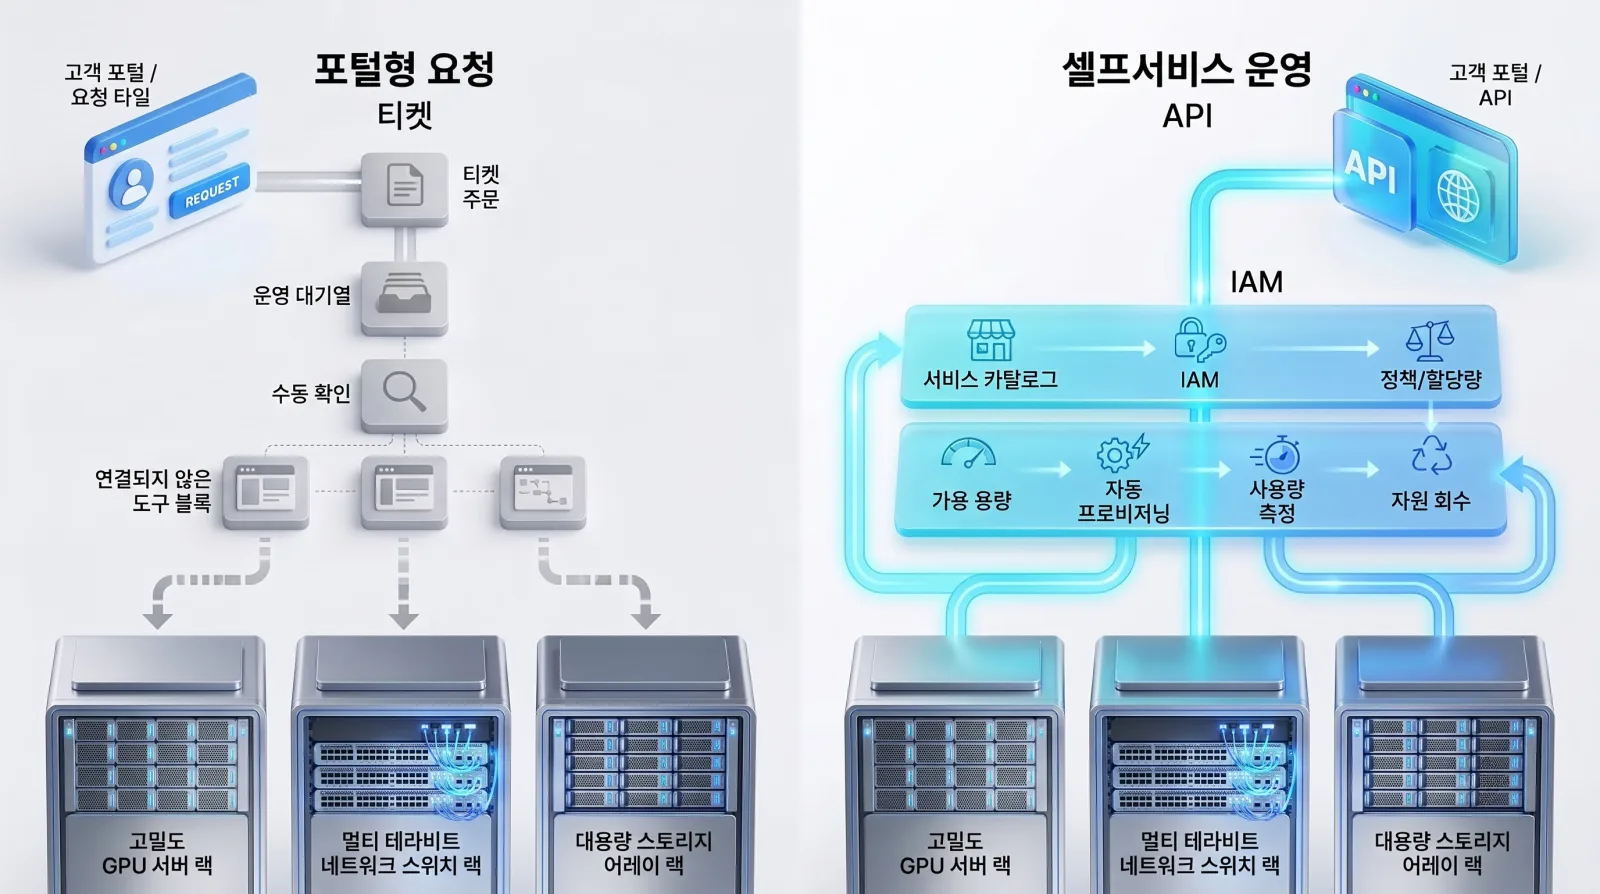
핵심은 사람을 완전히 없애는 것이 아닙니다.
반복 가능한 정상 흐름을 시스템이 처리하고, 사람이 예외와 정책을 관리할 수 있게 만드는 것
입니다.
셀프서비스와 온디맨드는 같은 말일까요?
두 개념은 밀접하지만 완전히 같은 말은 아닙니다.
셀프서비스는 “누가 어떻게 요청하는가”에 더 가깝습니다.
고객이 필요한 서비스를 직접 선택하고 요청할 수 있는 구조입니다.
온디맨드는 “필요한 자원을 필요할 때 제공받고 반환할 수 있는가”에 더 가깝습니다.
실제 클라우드에서는 두 개념이 함께 나타나는 경우가 많습니다.
고객이 셀프서비스 포털이나 API에서 GPU를 요청하고, 시스템이 가용 용량과 정책을 확인한 뒤 자원을 제공한다면 셀프서비스 + 온디맨드 구조가 됩니다.
하지만 예약형 서비스도 셀프서비스 주문이 가능할 수 있고, 온디맨드 요청이라도 일부 환경에서는 운영 승인 절차가 포함될 수 있습니다.
따라서 둘을 같은 단어로 취급하기보다 역할을 나누어 이해하는 편이 좋습니다.
전용 베어메탈 GPU도 셀프서비스가 될 수 있을까요?
가능합니다.
셀프서비스가 반드시 VM이나 공유 GPU를 의미하지는 않습니다.
고객이 전용 베어메탈 GPU 서버를 선택하고, 시스템이:
- 가용 서버 확인
- 예약
- 프로비저닝
- 네트워크 / 스토리지 구성
- 접근 권한 발급
- 사용 종료 후 초기화
를 일관되게 처리할 수 있다면 전용 물리 서버도 클라우드 방식으로 제공할 수 있습니다.
즉:
셀프서비스 여부는 가상화 여부보다 주문과 운영 흐름이 어떻게 구성되어 있는가에 달려 있습니다.
실패했을 때도 셀프서비스여야 합니다
정상적인 주문만 자동화하면 실제 운영에서는 문제가 생길 수 있습니다.
예를 들어:
- GPU 예약 성공
- 네트워크 프로비저닝 실패
상태가 발생했다고 해보겠습니다.
이때 시스템은:
- 재시도할 것인지
- GPU 예약을 유지할 것인지
- 일부 자원을 정리할 것인지
- 고객에게 어떤 상태를 보여줄 것인지
- 과금 시작을 막을 것인지
를 일관되게 처리할 수 있어야 합니다.
셀프서비스의 품질은 “버튼을 눌렀을 때 빨리 만들어지는가?”뿐 아니라:
정상과 실패 상태 모두에서 서비스 상태가 일관되게 관리되는가?
로 판단해야 합니다.
Thaki Cloud는 이 문제를 어떻게 볼까요?
Thaki Cloud의 Thaki NeoCloud OS 구조는 다음과 같습니다.
Customer Infrastructure → Thaki NeoCloud OS → Customer NeoCloud Service
Thaki NeoCloud OS는 GPU와 AI 인프라를 보유한 사업자가 자체 브랜드의 Self-Service·On-demand NeoCloud 서비스를 구축하고 운영할 수 있도록 지원하는 클라우드 플랫폼입니다.
지원되는 배포 환경에서는 서비스 카탈로그, 프로비저닝, 테넌시, 자원 할당 / 스케줄링, 사용량 측정, 과금 연동, 관측과 자원 라이프사이클 같은 운영 영역을 연결하는 역할을 할 수 있습니다.
실제 적용 범위와 연동 방식은 고객 환경과 프로젝트별로 확인해야 합니다.
정리하면
셀프서비스 클라우드의 핵심은 고객 포털이 아닙니다.
고객의 요청이:
서비스 카탈로그 → IAM / 정책 → 가용 용량 → 프로비저닝 → 사용 → 측정 → 종료 / 회수
로 연결되는 운영 구조가 핵심입니다.
고객은 서비스를 직접 소비하고, 운영자는 반복 요청을 일일이 수동 처리하는 대신 정책과 예외를 관리합니다.
이 구조가 갖춰져야 인프라가 실제 클라우드 서비스 경험으로 바뀝니다.
FAQ
셀프서비스 클라우드는 포털이 반드시 필요한가요?
포털은 대표적인 접근 방식이지만 API를 통해서도 셀프서비스를 제공할 수 있습니다. 핵심은 요청이 실제 서비스 제공 흐름과 연결되는 것입니다.
셀프서비스는 모든 요청을 자동 승인한다는 뜻인가요?
아닙니다. IAM, 정책, 할당량, 계약 조건과 가용 용량에 따라 요청이 제한되거나 승인 절차가 적용될 수 있습니다.
전용 GPU 서버도 셀프서비스로 제공할 수 있나요?
가능합니다. 물리 서버도 API 기반 프로비저닝과 운영 흐름을 통해 클라우드 방식으로 제공할 수 있습니다.
셀프서비스와 온디맨드는 같은 뜻인가요?
밀접하지만 다릅니다. 셀프서비스는 고객이 직접 요청하는 방식, 온디맨드는 필요한 자원을 필요할 때 제공받고 반환하는 소비 방식에 더 가깝습니다.
셀프서비스를 구축하면 운영 인력이 필요 없나요?
아닙니다. 반복 가능한 정상 흐름을 자동화하고 운영 인력은 정책, 예외, 장애, 용량과 서비스 품질을 관리하는 방향으로 역할이 바뀝니다.
GPU / AI 인프라를 셀프서비스 클라우드로 전환하고 계신가요?
보유 인프라를 고객이 직접 주문하고 사용할 수 있는 서비스로 전환할 때 서비스 카탈로그, 정책, 프로비저닝, 사용량 측정과 자원 회수가 어떻게 연결되어야 하는지 Thaki Cloud와 함께 검토해 보세요.
문의하기참고 자료
관련 아티클
- GPU Cloud란 무엇인가? 개념, 작동 방식, GPUaaS와의 차이GPU Cloud는 데이터센터의 GPU를 네트워크를 통해 필요할 때 사용하는 클라우드 컴퓨팅 방식입니다. GPUaaS와의 차이, 작동 방식, Bare Metal·Virtual GPU 유형, 활용 사례와 운영 구조를 설명합니다.
- AI Factory란 무엇인가? AI 데이터센터와 무엇이 다른가?AI Factory는 AI 워크로드를 반복적으로 개발·학습·배포·운영하기 위한 통합 인프라와 운영 환경입니다. AI 데이터센터와의 차이, 핵심 구성 요소, AI Lifecycle, GPU Cloud와의 관계를 설명합니다.
- GPUaaS란 무엇인가? GPU as a Service의 구조와 핵심 기능GPUaaS는 GPU 연산 자원을 직접 구매하지 않고 서비스 형태로 사용하는 방식입니다. GPU Cloud와의 차이, 작동 방식, Bare Metal·Virtual GPU 제공 형태, 운영 기능과 선택 기준을 설명합니다.
- Private AI Cloud란 무엇인가?Private AI Cloud는 단일 조직 전용의 Private Cloud 운영 모델에 GPU·AI 플랫폼·데이터·보안·거버넌스를 결합한 AI 환경입니다. Public AI Cloud, On-Prem AI, Sovereign AI, Air-Gapped AI와의 차이와 구축 고려사항을 설명합니다.
- GPU 서버가 있다고 GPU Cloud가 되는 것은 아닙니다GPU 서버를 보유하거나 호스팅한다고 자동으로 GPU Cloud가 되는 것은 아닙니다. GPU Hosting과 GPU Cloud의 차이, Self-Service·Provisioning·Scheduling·Metering 등 Cloud 운영에 필요한 핵심 기능을 설명합니다.
- NeoCloud란 무엇인가? AI 시대의 GPU 중심 클라우드NeoCloud는 GPU와 AI Workload에 특화된 Cloud Infrastructure Provider를 설명할 때 사용되는 산업 용어입니다. 기존 Hyperscaler, GPU Cloud, GPUaaS와의 관계와 Thaki Cloud의 NeoCloud Enablement 관점을 설명합니다.
- AI Factory의 다음 단계는 Cloud Service입니다AI Factory를 구축하는 것과 고객이 실제로 사용할 수 있는 Cloud Service를 운영하는 것은 다릅니다. Provisioning, Multi-Tenancy, GPU Scheduling, Metering, Billing, SLA 등 서비스화에 필요한 운영 계층을 설명합니다.
- AI 인프라를 Cloud Business로 전환한다는 것은 무엇인가?GPU와 AI 인프라를 보유하는 것과 실제 Cloud Business를 운영하는 것은 다릅니다. Infrastructure → Product → On-demand Cloud Service 전환 과정과 Service Catalog, Provisioning, Metering, Billing, SLA 등 사업화에 필요한 운영 구조를 설명합니다.
- Bare Metal GPU란? 가상화 GPU와의 차이와 활용 방식Bare Metal GPU의 개념과 GPU VM, vGPU, GPU Passthrough의 차이를 알아보세요. 전용성, 성능 일관성, 유연성, 자원 효율, Provisioning 관점에서 어떤 방식이 적합한지 설명합니다.
- Private AI Cloud와 Public AI Cloud의 차이Private AI Cloud와 Public AI Cloud를 전용성, 통제 범위, 확장성, Managed Service, 운영 책임, 비용 구조 관점에서 비교합니다. 어떤 AI Workload에 각각 적합한지 알아보세요.
- GPU Scheduling이란? AI Cloud에서 GPU 자원을 배분하는 방법GPU Scheduling의 개념과 Queue, Priority, Quota, GPU Type, Topology, Multi-GPU Job, Resource Fragmentation을 알아보세요. GPU Cloud에서 Scheduling과 Provisioning이 어떻게 다른지도 설명합니다.
- AI Factory 구축 이후에 필요한 운영 플랫폼은 무엇인가?AI Factory 구축 이후 실제 운영 단계에서 필요한 Provisioning, GPU Scheduling, 사용자·Policy 관리, Observability, Capacity Management, Metering과 Lifecycle Automation을 알아보세요.
- On-Prem AI란? 기업이 자체 환경에서 AI를 운영하는 이유On-Prem AI의 개념과 Private AI Cloud와의 차이, 기업이 데이터·모델·네트워크·지연시간·운영 통제를 이유로 자체 환경에서 AI를 운영하는 경우와 Trade-off를 알아보세요.
- GPU Multi-Tenancy란? 여러 고객이 GPU 인프라를 안전하게 사용하는 구조GPU Multi-Tenancy의 개념과 Tenant Isolation, Dedicated GPU, vGPU, MIG, Kubernetes Namespace, Quota, Scheduling, Network·Storage 분리와 Usage 관리 구조를 알아보세요.
- GPU Provisioning이란? 주문에서 사용 가능 상태까지의 자동화GPU Provisioning의 개념과 GPU 요청 이후 Compute, Network, Storage, Image, Runtime, Access를 준비해 실제 사용 가능한 환경으로 만드는 자동화 과정을 알아보세요.
- AI Factory를 Multi-Customer Cloud Service로 전환하려면AI Factory를 여러 고객이 사용하는 Cloud Service로 전환할 때 필요한 Service Catalog, Multi-Tenancy, Provisioning, Scheduling, Metering, Billing, SLA와 Lifecycle을 알아보세요.
- GPU 클라우드 사업화 준비도 체크리스트: 무엇을 점검해야 할까?GPU 서버를 보유했다고 바로 GPU 클라우드 서비스를 판매할 수 있는 것은 아닙니다. 서비스 상품화, 멀티테넌시, 프로비저닝, 사용량 측정, 과금, SLA와 자원 라이프사이클을 12개 실무 항목으로 점검합니다.
- GPU 클라우드 수익성 분석: 가동률보다 중요한 것은 무엇일까?GPU 사용률과 과금 가능 시간은 같은 지표가 아닙니다. 가상의 32-GPU 계산 예시를 통해 판매 가능 용량, 과금 가능 GPU 시간, 실현 단가, 고정비·변동비와 손익분기점을 설명합니다.
- GPU 클라우드 직접 구축 vs. 통합 운영 플랫폼: 무엇이 더 합리적일까?OpenStack, Kubernetes, Prometheus 같은 오픈소스로 GPU 클라우드를 구축할 수 있습니다. 직접 통합과 운영 플랫폼 도입을 연동, 실패 처리, 과금, 확장성과 3–5년 총소유비용 관점에서 비교합니다.
- On-demand GPU Service란? 필요한 GPU를 필요할 때 제공받는 방식온디맨드 GPU는 Shared GPU나 Spot GPU와 같은 말이 아닙니다. 요청, 가용 용량, 프로비저닝, 사용량 측정과 반환이 어떻게 연결되는지, 전용 베어메탈도 온디맨드 방식으로 제공할 수 있는지 설명합니다.
- Cloud Service Catalog란? GPU 인프라를 서비스 상품으로 만드는 첫 단계클라우드 서비스 카탈로그는 GPU 재고 목록이나 가격표가 아닙니다. GPU·네트워크·스토리지를 고객이 주문할 수 있는 상품으로 정의하고 정책, 프로비저닝, 과금과 연결하는 구조를 설명합니다.
- 데이터센터가 GPU Hosting에서 GPU Cloud로 전환하려면GPU Hosting에서 GPU Cloud로의 전환은 하드웨어 교체보다 운영 모델 변화에 가깝습니다. 서비스 카탈로그, 셀프서비스, 프로비저닝, 고객 분리, 사용량 측정·과금과 자원 회수를 어떻게 추가해야 하는지 설명합니다.