기업용 AI 인프라 구축 체크리스트: GPU부터 거버넌스까지
기업이 AI Infrastructure를 구축할 때 가장 먼저 나오는 질문은 종종 이것입니다.
“어떤 GPU를 사야 할까요?”
중요한 질문입니다.
하지만 첫 번째 질문으로는 너무 빠릅니다.
같은 GPU라도:
- Large Model Training
- Fine-tuning
- Real-time Inference
- RAG
- Enterprise AI Agent
중 어떤 Workload를 운영하느냐에 따라 필요한 Server, Network, Storage, Runtime과 Operations가 달라집니다.
Data가 민감한지, 외부 Cloud를 사용할 수 있는지, 24×7 Service인지, 여러 팀이 함께 쓰는지에 따라서도 Architecture가 달라집니다.
그래서 기업 AI Infrastructure는:
GPU → Architecture
순서가 아니라:
Workload / Data / Control Requirement → Architecture → GPU / Compute
순서로 접근하는 편이 훨씬 안전합니다.
이 글에서는 구축 전 확인해야 할 내용을 12개 실무 항목으로 정리합니다.
먼저 “무엇을 돌릴 것인가?”를 정의해야 합니다
AI Infrastructure에서 가장 비싼 실수 중 하나는 Workload가 명확하지 않은 상태에서 Hardware부터 결정하는 것입니다.
예를 들어 Training과 Inference는 같은 AI라도 Infrastructure 요구가 다를 수 있습니다.
Training
- 대량 GPU
- 높은 GPU-to-GPU Bandwidth
- Checkpoint / Dataset I/O
- 장시간 Job
- Multi-node Scheduling
이 중요할 수 있습니다.
Inference
- Latency
- Throughput
- Availability
- Model Loading
- Autoscaling / Capacity
이 더 중요할 수 있습니다.
RAG
GPU뿐 아니라:
- Document Pipeline
- Embedding
- Vector Database
- Storage
- Data Governance
가 중요합니다.
Agent
Model Endpoint 외에도:
- Tool / API Access
- Identity
- Audit
- Policy
- Application Integration
을 함께 봐야 합니다.
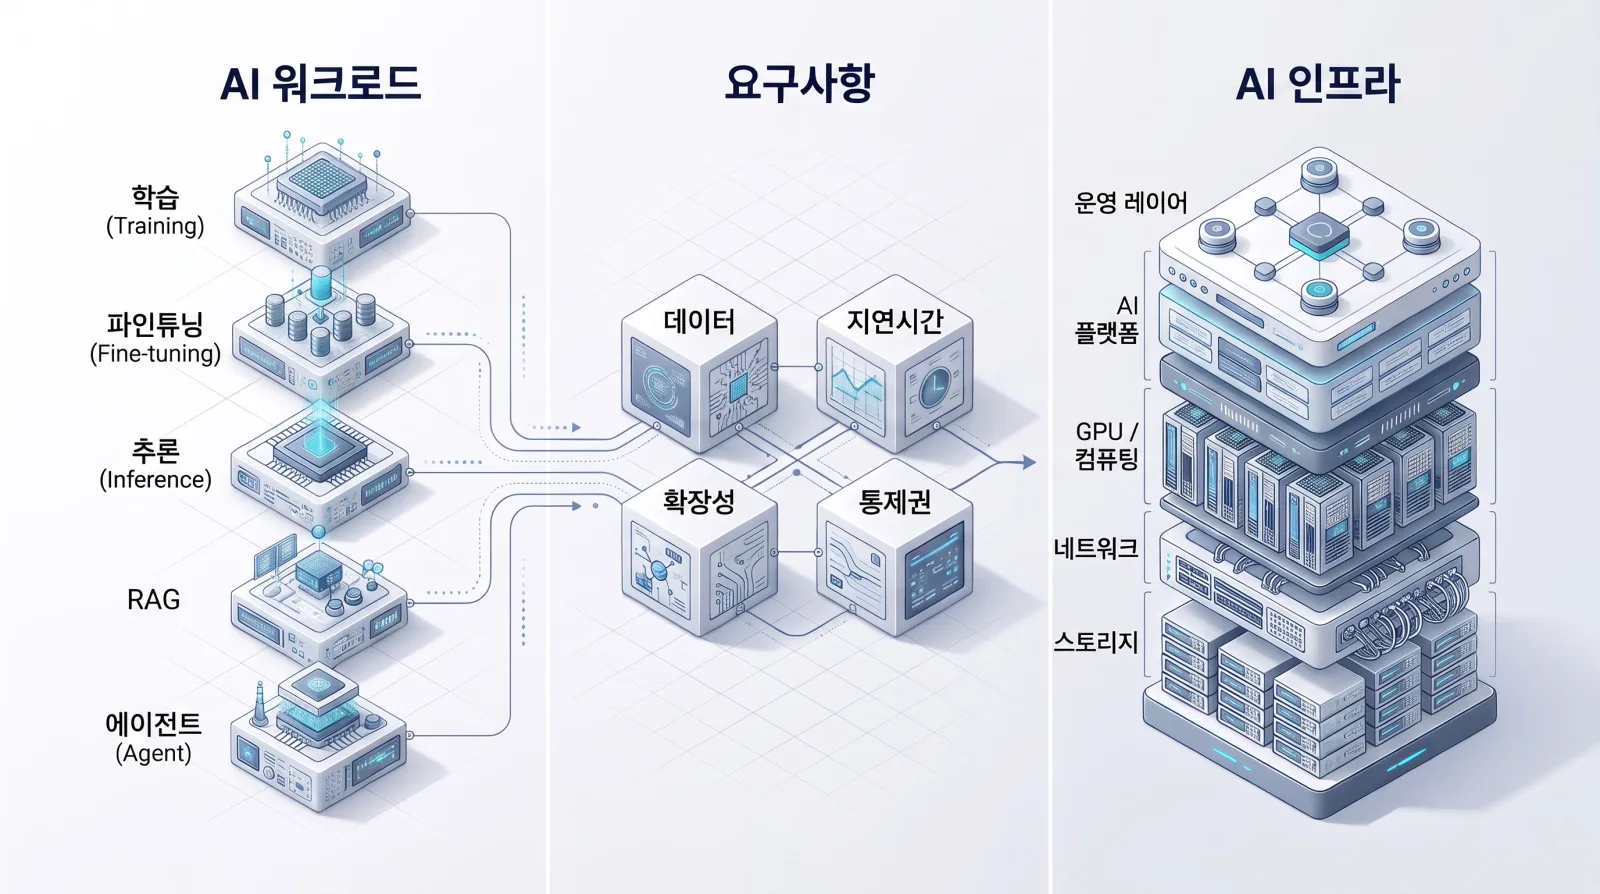
즉 “AI Infrastructure”는 하나의 고정된 Architecture가 아닙니다.
12개 실무 체크리스트
이 Checklist는 공식 인증 기준이 아닙니다.
구축 전에 Architecture Gap을 찾기 위한 실무 점검표입니다.
A. 요구사항 정의
1. Workload — 무엇을 실행할 것인가?
먼저 실제 Workload를 분류합니다.
- Training
- Fine-tuning
- Batch Inference
- Real-time Inference
- RAG
- Agent
- HPC / Simulation
중 무엇이 필요한가?
동시에 몇 개의 Workload가 실행될 것인가?
Model Size와 Context, Request Pattern은 어떠한가?
Workload가 정의되어야 Compute와 Capacity를 계산할 수 있습니다.
2. Data / Model — 무엇을 저장하고 이동할 것인가?
AI는 Compute만큼 Data Pipeline이 중요합니다.
확인할 내용:
- Dataset Size
- Data Growth
- Sensitive / Regulated Data
- Training Data
- Model Weight
- Checkpoint
- Embedding / Vector Index
- Backup / Retention
- Model Registry
입니다.
Data가 어디에 있고 얼마나 빠르게 GPU에 공급되어야 하는지에 따라 Storage와 Network가 달라집니다.
3. Deployment / Service Model — 누구를 위해 어디에서 운영할 것인가?
다음 중 어떤 구조인가?
- Public Cloud
- Private Cloud
- On-Prem
- Hosted Private
- Hybrid
- Air-Gapped
- Internal Shared AI Platform
- Customer-facing GPU / AI Cloud
이 선택은 Location만의 문제가 아닙니다.
누가 운영하고, 누가 주문하고, 어떤 Data / Security Requirement가 있는지까지 연결됩니다.
B. Infrastructure
4. GPU / Compute — GPU Model보다 필요한 Compute Shape를 먼저 봅니다
확인할 내용:
- GPU Memory
- Compute Capability
- Number of GPUs per Node
- CPU / RAM Balance
- Accelerator Interconnect
- Power / Cooling Requirement
입니다.
특정 GPU 모델이 유명하다고 해서 모든 Workload에 최적이라는 뜻은 아닙니다.
Workload Profile과 Software Compatibility를 기준으로 선택해야 합니다.
5. Network — GPU 사이의 Network가 Bottleneck이 되지 않는가?
Multi-GPU / Multi-node Training에서는 Network가 성능에 직접 영향을 줄 수 있습니다.
Inference에서도:
- Data Ingress
- Model Loading
- Storage Access
- Service Traffic
을 함께 봐야 합니다.
확인할 내용:
- Node 간 Bandwidth
- Latency
- Topology
- East-West Traffic
- Storage Network
- External / Enterprise Network
입니다.
GPU 성능만 보고 Network를 나중에 설계하면 Infrastructure 전체가 기대한 성능을 내지 못할 수 있습니다.
6. Storage — Model과 Dataset을 GPU에 어떻게 공급할 것인가?
AI Storage는 단순 Capacity 문제만이 아닙니다.
Training Dataset, Checkpoint, Model Weight, Vector Data와 Log는 서로 다른 I/O Pattern을 가질 수 있습니다.
확인할 내용:
- Capacity
- Throughput
- IOPS
- Shared vs Local
- Object / File / Block
- Backup
- Data Lifecycle
입니다.
C. Platform / Operations
7. AI Platform / Runtime — GPU 위에서 무엇을 운영할 것인가?
Hardware가 준비되어도 실제 AI Workload를 실행하려면 Software Stack이 필요합니다.
예:
- OS / Driver
- Accelerator Runtime
- Container
- Kubernetes
- Scheduler
- Model Serving
- Notebook / Development Environment
- Model Registry
- Data / MLOps Tool
입니다.
중요한 것은 Tool을 많이 설치하는 것이 아니라 Workload Lifecycle을 얼마나 단순하게 만들 수 있는가입니다.
8. Resource Operations — GPU를 어떻게 배분하고 준비할 것인가?
여러 Team이나 Workload가 GPU를 사용하면 다음이 필요할 수 있습니다.
- Provisioning
- Scheduling
- Queue
- Priority
- Quota
- Reservation
- Resource Allocation
- Topology-aware Placement
GPU가 “비어 있다”는 것과 특정 Job이 실제로 Scheduling 가능한 것은 다를 수 있습니다.
또 Internal Platform과 External Customer-facing Cloud에서는 필요한 운영 범위가 달라집니다.
9. Observability / Reliability / Lifecycle — 운영 상태를 어떻게 알 것인가?
AI Infrastructure도 Production System입니다.
확인할 내용:
- GPU Health
- Server Health
- Network
- Storage
- Job State
- Capacity
- Alert
- Log
- Failure Recovery
- Resource Cleanup
- Upgrade
- Backup / Restore
입니다.
Monitoring은 상태를 보여주지만 Operations는 문제를 해결하고 Resource를 다시 사용 가능한 상태로 만드는 Lifecycle까지 포함합니다.
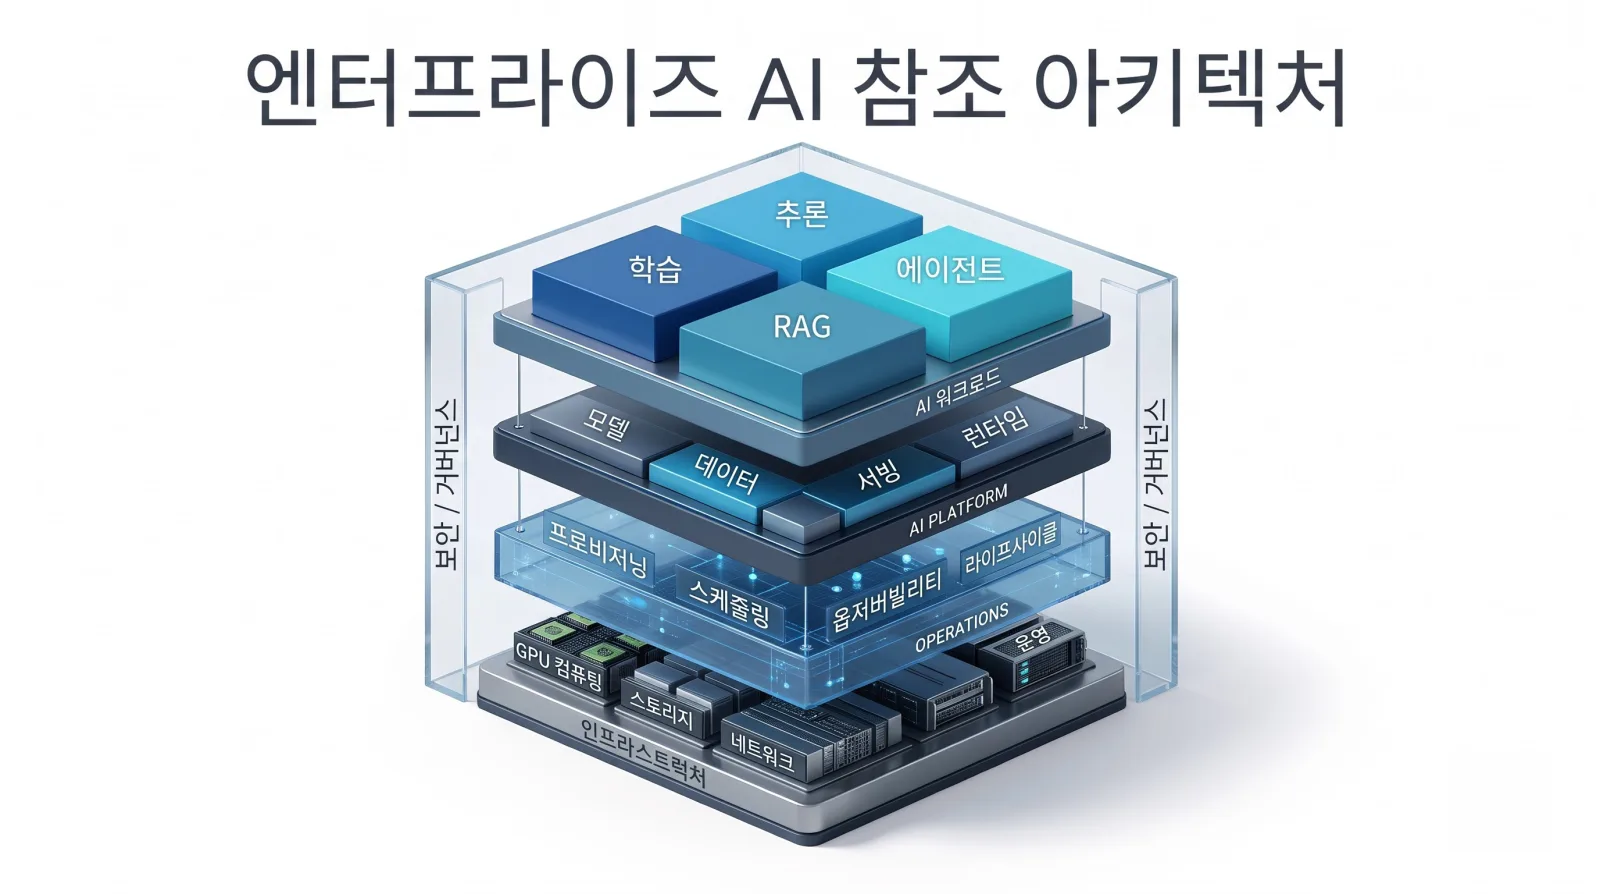
D. Control / Business
10. Security / Access / Governance — 누가 무엇을 할 수 있는가?
AI는 Data와 Model이라는 새로운 Asset를 다룹니다.
따라서:
- Organization / User
- IAM
- Least Privilege
- Credential
- Network Boundary
- Data Access
- Model Access
- Audit
- Key Management
- Artifact Approval
을 함께 설계해야 합니다.
NIST AI RMF도 AI Risk Management를 기술 기능 하나가 아니라 Governance, Mapping, Measurement와 Management를 포함하는 Lifecycle 문제로 봅니다.
특정 Framework를 그대로 Checklist로 복사하는 것이 아니라 조직 Risk에 맞는 Governance를 운영해야 합니다.
11. Capacity / Scalability — 지금 몇 개가 필요한가보다 어떻게 늘릴 것인가?
AI Infrastructure는 초기 PoC와 Production Capacity가 크게 다를 수 있습니다.
확인할 내용:
- 현재 Peak Demand
- Growth
- Reservation
- Headroom
- Maintenance Capacity
- Failure Capacity
- New GPU Generation
- Additional Site
- Expansion Lead Time
입니다.
Capacity Planning은 GPU 구매 숫자뿐 아니라 Power, Cooling, Network, Storage와 Software Operations 확장까지 포함해야 합니다.
12. Economics / Operating Responsibility — 누가 운영하고 총비용은 얼마인가?
마지막으로:
- Hardware
- Facility
- Power
- Cooling
- Network
- Storage
- Software
- Platform Engineering
- Operations
- Support
- Upgrade
- Security
- Financing
등 전체 비용을 봐야 합니다.
또 중요한 질문은:
누가 이 환경을 3~5년 동안 운영할 것인가?
입니다.
Build / Buy / Managed Service 선택은 License Price만이 아니라 Internal Engineering과 Operating Responsibility를 함께 봐야 합니다.
Checklist를 한 번에 보면
요구사항
1. Workload
2. Data / Model
3. Deployment / Service Model
Infrastructure
4. GPU / Compute
5. Network
6. Storage
Platform / Operations
7. AI Platform / Runtime
8. Provisioning / Scheduling / Resource Operations
9. Observability / Reliability / Lifecycle
Control / Business
10. Security / Access / Governance
11. Capacity / Scalability
12. Economics / Operating Responsibility
높은 점수면 좋은 Architecture일까요?
이 Checklist는 점수를 합산하기 위한 것이 아닙니다.
예를 들어 12개 중 11개가 잘 준비되어 있어도:
- Sensitive Data Access
- Network Bottleneck
- Insufficient Power
- No Recovery Plan
중 하나가 Critical Gap이라면 Production Deployment에 큰 문제가 될 수 있습니다.
따라서 중요한 것은 항목 수보다:
Workload에 Critical한 Requirement가 빠지지 않았는가?
입니다.
Public / Private / On-Prem / Hybrid 중 무엇이 정답일까요?
하나의 정답은 없습니다.
Public Cloud
빠른 접근, 다양한 Managed Service, Global Scale이 중요할 수 있습니다.
Private / On-Prem
Data / Infrastructure Control, Local Integration, predictable long-running Workload가 중요할 수 있습니다.
Hybrid
Workload별로 서로 다른 Environment를 사용하는 방식입니다.
예:
- Training은 Dedicated Infrastructure
- Sensitive RAG는 Private
- Burst Workload는 Public Cloud
같은 구조입니다.
Architecture는 Company Philosophy보다 Workload Requirement에서 시작하는 것이 좋습니다.
AI Infrastructure와 NeoCloud는 어떻게 연결될까요?
기업 내부 AI Infrastructure를 구축하는 것과 Customer-facing NeoCloud Service를 만드는 것은 다른 목표입니다.
Internal AI Platform은:
- Employee / Research Team
- Internal Workload
- Enterprise Governance
가 중심입니다.
NeoCloud Service는 여기에:
- Service Catalog
- Customer / Tenant
- Self-Service
- Metering / Billing
- SLA
- Commercial Lifecycle
이 추가될 수 있습니다.
따라서 AI Infrastructure가 충분히 잘 구축되었다고 자동으로 Cloud Business가 되는 것은 아닙니다.
Thaki Cloud는 이 문제를 어떻게 볼까요?
Thaki Cloud는 Cloud Services와 On-Premise Solutions를 모두 제공하는 NeoCloud 기업입니다.
기업이 자체 환경에서 AI Infrastructure를 운영하는 경우에는 Private / On-Prem AI Architecture가 중요하고, Infrastructure Owner가 이를 자체 브랜드 Cloud Service로 사업화하려는 경우에는 Thaki NeoCloud OS의 역할이 달라집니다.
Thaki NeoCloud OS의 Canonical Architecture는:
Customer Infrastructure → Thaki NeoCloud OS → Customer NeoCloud Service
입니다.
즉 먼저 Workload와 Infrastructure Requirement를 정의하고, 그 위에 Internal AI Platform을 만들 것인지 Customer-facing Cloud Service를 만들 것인지에 따라 필요한 Operations Layer가 달라집니다.
정리하면
기업 AI Infrastructure 구축의 출발점은 GPU가 아닙니다.
먼저:
Workload → Data → Control Requirement → Service Model
을 정의해야 합니다.
그 다음:
Compute → Network → Storage → Platform → Operations → Governance → Economics
를 설계합니다.
GPU는 이 Architecture 안에서 매우 중요한 구성요소이지만 전체 Architecture를 대신하지는 않습니다.
FAQ
GPU 모델을 먼저 선택하면 안 되나요?
Workload가 명확한 경우에는 가능하지만 일반적으로 Workload와 Data Requirement를 먼저 정의하는 것이 Architecture Risk를 줄이는 데 도움이 됩니다.
AI Infrastructure에 Kubernetes가 반드시 필요한가요?
아닙니다. Workload, Team, Scale와 운영 모델에 따라 적합성이 달라집니다.
모든 기업이 On-Prem AI를 구축해야 하나요?
아닙니다. Public, Private, On-Prem과 Hybrid 가운데 Workload에 맞는 구조를 선택해야 합니다.
Security와 Governance는 구축 후 추가하면 되나요?
가능하지만 Architecture 초기에 Access, Data, Key, Audit와 Operating Responsibility를 반영하는 편이 재설계 위험을 줄일 수 있습니다.
이 12개 Checklist는 공식 표준인가요?
아닙니다. Enterprise AI Infrastructure Planning을 위한 실무 점검 Framework입니다.
Enterprise AI Infrastructure를 설계하고 계신가요?
GPU 선택부터 시작하기보다 Workload, Data, Platform, Security, Operations와 Economics를 하나의 Architecture로 함께 검토하고 있다면 Thaki Cloud와 구축 방향을 점검해 보세요.
문의하기참고 자료
관련 아티클
- GPU Cloud란 무엇인가? 개념, 작동 방식, GPUaaS와의 차이GPU Cloud는 데이터센터의 GPU를 네트워크를 통해 필요할 때 사용하는 클라우드 컴퓨팅 방식입니다. GPUaaS와의 차이, 작동 방식, Bare Metal·Virtual GPU 유형, 활용 사례와 운영 구조를 설명합니다.
- AI Factory란 무엇인가? AI 데이터센터와 무엇이 다른가?AI Factory는 AI 워크로드를 반복적으로 개발·학습·배포·운영하기 위한 통합 인프라와 운영 환경입니다. AI 데이터센터와의 차이, 핵심 구성 요소, AI Lifecycle, GPU Cloud와의 관계를 설명합니다.
- GPUaaS란 무엇인가? GPU as a Service의 구조와 핵심 기능GPUaaS는 GPU 연산 자원을 직접 구매하지 않고 서비스 형태로 사용하는 방식입니다. GPU Cloud와의 차이, 작동 방식, Bare Metal·Virtual GPU 제공 형태, 운영 기능과 선택 기준을 설명합니다.
- Private AI Cloud란 무엇인가?Private AI Cloud는 단일 조직 전용의 Private Cloud 운영 모델에 GPU·AI 플랫폼·데이터·보안·거버넌스를 결합한 AI 환경입니다. Public AI Cloud, On-Prem AI, Sovereign AI, Air-Gapped AI와의 차이와 구축 고려사항을 설명합니다.
- GPU 서버가 있다고 GPU Cloud가 되는 것은 아닙니다GPU 서버를 보유하거나 호스팅한다고 자동으로 GPU Cloud가 되는 것은 아닙니다. GPU Hosting과 GPU Cloud의 차이, Self-Service·Provisioning·Scheduling·Metering 등 Cloud 운영에 필요한 핵심 기능을 설명합니다.
- NeoCloud란 무엇인가? AI 시대의 GPU 중심 클라우드NeoCloud는 GPU와 AI Workload에 특화된 Cloud Infrastructure Provider를 설명할 때 사용되는 산업 용어입니다. 기존 Hyperscaler, GPU Cloud, GPUaaS와의 관계와 Thaki Cloud의 NeoCloud Enablement 관점을 설명합니다.
- AI Factory의 다음 단계는 Cloud Service입니다AI Factory를 구축하는 것과 고객이 실제로 사용할 수 있는 Cloud Service를 운영하는 것은 다릅니다. Provisioning, Multi-Tenancy, GPU Scheduling, Metering, Billing, SLA 등 서비스화에 필요한 운영 계층을 설명합니다.
- AI 인프라를 Cloud Business로 전환한다는 것은 무엇인가?GPU와 AI 인프라를 보유하는 것과 실제 Cloud Business를 운영하는 것은 다릅니다. Infrastructure → Product → On-demand Cloud Service 전환 과정과 Service Catalog, Provisioning, Metering, Billing, SLA 등 사업화에 필요한 운영 구조를 설명합니다.
- Bare Metal GPU란? 가상화 GPU와의 차이와 활용 방식Bare Metal GPU의 개념과 GPU VM, vGPU, GPU Passthrough의 차이를 알아보세요. 전용성, 성능 일관성, 유연성, 자원 효율, Provisioning 관점에서 어떤 방식이 적합한지 설명합니다.
- Private AI Cloud와 Public AI Cloud의 차이Private AI Cloud와 Public AI Cloud를 전용성, 통제 범위, 확장성, Managed Service, 운영 책임, 비용 구조 관점에서 비교합니다. 어떤 AI Workload에 각각 적합한지 알아보세요.
- GPU Scheduling이란? AI Cloud에서 GPU 자원을 배분하는 방법GPU Scheduling의 개념과 Queue, Priority, Quota, GPU Type, Topology, Multi-GPU Job, Resource Fragmentation을 알아보세요. GPU Cloud에서 Scheduling과 Provisioning이 어떻게 다른지도 설명합니다.
- AI Factory 구축 이후에 필요한 운영 플랫폼은 무엇인가?AI Factory 구축 이후 실제 운영 단계에서 필요한 Provisioning, GPU Scheduling, 사용자·Policy 관리, Observability, Capacity Management, Metering과 Lifecycle Automation을 알아보세요.
- On-Prem AI란? 기업이 자체 환경에서 AI를 운영하는 이유On-Prem AI의 개념과 Private AI Cloud와의 차이, 기업이 데이터·모델·네트워크·지연시간·운영 통제를 이유로 자체 환경에서 AI를 운영하는 경우와 Trade-off를 알아보세요.
- GPU Multi-Tenancy란? 여러 고객이 GPU 인프라를 안전하게 사용하는 구조GPU Multi-Tenancy의 개념과 Tenant Isolation, Dedicated GPU, vGPU, MIG, Kubernetes Namespace, Quota, Scheduling, Network·Storage 분리와 Usage 관리 구조를 알아보세요.
- GPU Provisioning이란? 주문에서 사용 가능 상태까지의 자동화GPU Provisioning의 개념과 GPU 요청 이후 Compute, Network, Storage, Image, Runtime, Access를 준비해 실제 사용 가능한 환경으로 만드는 자동화 과정을 알아보세요.
- AI Factory를 Multi-Customer Cloud Service로 전환하려면AI Factory를 여러 고객이 사용하는 Cloud Service로 전환할 때 필요한 Service Catalog, Multi-Tenancy, Provisioning, Scheduling, Metering, Billing, SLA와 Lifecycle을 알아보세요.
- GPU 클라우드 사업화 준비도 체크리스트: 무엇을 점검해야 할까?GPU 서버를 보유했다고 바로 GPU 클라우드 서비스를 판매할 수 있는 것은 아닙니다. 서비스 상품화, 멀티테넌시, 프로비저닝, 사용량 측정, 과금, SLA와 자원 라이프사이클을 12개 실무 항목으로 점검합니다.
- GPU 클라우드 수익성 분석: 가동률보다 중요한 것은 무엇일까?GPU 사용률과 과금 가능 시간은 같은 지표가 아닙니다. 가상의 32-GPU 계산 예시를 통해 판매 가능 용량, 과금 가능 GPU 시간, 실현 단가, 고정비·변동비와 손익분기점을 설명합니다.
- GPU 클라우드 직접 구축 vs. 통합 운영 플랫폼: 무엇이 더 합리적일까?OpenStack, Kubernetes, Prometheus 같은 오픈소스로 GPU 클라우드를 구축할 수 있습니다. 직접 통합과 운영 플랫폼 도입을 연동, 실패 처리, 과금, 확장성과 3–5년 총소유비용 관점에서 비교합니다.
- Self-Service Cloud란? 고객이 직접 주문하고 사용하는 클라우드 서비스셀프서비스 클라우드는 단순한 포털이 아닙니다. 서비스 카탈로그, IAM, 정책·할당량, 가용 용량, 프로비저닝, 사용량 측정과 자원 회수가 어떻게 연결되어야 하는지 설명합니다.
- On-demand GPU Service란? 필요한 GPU를 필요할 때 제공받는 방식온디맨드 GPU는 Shared GPU나 Spot GPU와 같은 말이 아닙니다. 요청, 가용 용량, 프로비저닝, 사용량 측정과 반환이 어떻게 연결되는지, 전용 베어메탈도 온디맨드 방식으로 제공할 수 있는지 설명합니다.
- Cloud Service Catalog란? GPU 인프라를 서비스 상품으로 만드는 첫 단계클라우드 서비스 카탈로그는 GPU 재고 목록이나 가격표가 아닙니다. GPU·네트워크·스토리지를 고객이 주문할 수 있는 상품으로 정의하고 정책, 프로비저닝, 과금과 연결하는 구조를 설명합니다.
- 데이터센터가 GPU Hosting에서 GPU Cloud로 전환하려면GPU Hosting에서 GPU Cloud로의 전환은 하드웨어 교체보다 운영 모델 변화에 가깝습니다. 서비스 카탈로그, 셀프서비스, 프로비저닝, 고객 분리, 사용량 측정·과금과 자원 회수를 어떻게 추가해야 하는지 설명합니다.
- 통신사가 보유 GPU 인프라로 자체 AI Cloud Service를 만드는 방법통신사가 보유한 데이터센터·네트워크·GPU 인프라를 고객용 AI Cloud Service로 확장하려면 무엇이 필요할까요? 서비스 상품화, 셀프서비스, 프로비저닝, 고객 분리, 사용량 측정과 운영 구조를 설명합니다.
- Sovereign AI Cloud란? 데이터 위치보다 중요한 통제 범위Sovereign AI는 데이터를 특정 국가에 저장하는 것만으로 완성되지 않습니다. 데이터, 관리자 접근, 키, 인프라, 모델, 운영, 법적 관할과 공급망 의존성을 어떤 범위까지 통제해야 하는지 설명합니다.
- Air-Gapped AI란? 망분리 환경에서 AI를 운영하는 방식Air-Gapped AI는 단순한 사설망이나 방화벽 환경과 다릅니다. 외부 자동 연결이 없는 환경에서 모델, 데이터, 패키지, 업데이트, 관측과 AI 운영을 어떻게 구성해야 하는지 설명합니다.