GPU 클라우드 사업화 준비도 체크리스트: 무엇을 점검해야 할까?
GPU 서버가 이미 설치되어 있고, AI 학습과 추론도 정상적으로 돌아갑니다.
그런데 다음 주 첫 외부 고객이 이렇게 요청한다고 가정해 보겠습니다.
“GPU 서버 8대를 일주일 동안 사용하고 싶습니다. 언제 받을 수 있고, 얼마이며, 사용이 끝나면 어떻게 되나요?”
이 질문에 즉시 답할 수 있을까요?
GPU 모델과 수량을 확인하는 것만으로는 부족합니다. 어떤 서비스로 판매할지, 주문을 어떻게 받을지, 고객을 어떻게 분리할지, 네트워크와 스토리지를 어떻게 준비할지, 사용량을 무엇으로 측정할지, 어떤 기준으로 청구할지, 종료 후 자원을 어떻게 정리해 다시 판매 가능한 상태로 돌릴지까지 연결되어야 합니다.
즉:
GPU 인프라를 보유하는 것, AI 워크로드를 잘 운영하는 것, 반복 가능한 고객용 클라우드 서비스를 운영하는 것은 서로 다른 준비 상태입니다.
이 글에서는 GPU 클라우드 사업화를 준비하는 사업자가 실제로 무엇을 점검해야 하는지 12개 항목으로 정리합니다.
세 가지 준비 상태는 다릅니다
GPU 클라우드 사업화에서 가장 먼저 구분해야 할 것은 “구축이 끝났는가?”라는 질문의 의미입니다.
1. 인프라 준비
GPU 서버, 네트워크, 스토리지가 설치되어 정상적으로 운영되는 상태입니다.
이 단계에서는 다음 질문에 답할 수 있습니다.
- GPU 하드웨어가 정상인가?
- 네트워크와 스토리지가 연결되는가?
- 하드웨어 상태와 기본 모니터링이 가능한가?
- 필요한 용량이 실제로 존재하는가?
중요한 기반이지만 아직 고객이 구매할 수 있는 서비스가 있다는 뜻은 아닙니다.
2. AI 워크로드 준비
인프라 위에서 학습, 파인튜닝, 추론 같은 AI 워크로드를 안정적으로 실행할 수 있는 상태입니다.
여기에는 GPU 런타임, 컨테이너, 스케줄러, AI 플랫폼과 워크로드 운영 기능이 포함될 수 있습니다.
하지만 내부 팀이 AI 워크로드를 잘 실행하는 것과 외부 고객이 GPU 서비스를 주문하고 사용하는 것은 다른 문제입니다.
3. 서비스 운영 준비
고객이 실제로 서비스를 선택하고 주문하고 사용할 수 있는 상태입니다.
여기서는 인프라뿐 아니라 다음이 연결되어야 합니다.
- 서비스 카탈로그
- 고객 / 조직 관리
- IAM / 할당량
- 멀티테넌시
- 주문 / 제공 절차
- 프로비저닝
- 스케줄링
- 사용량 측정
- 과금 / 정산
- SLA / 장애 대응
- 자원 회수 / 재할당
- 콘솔 / API
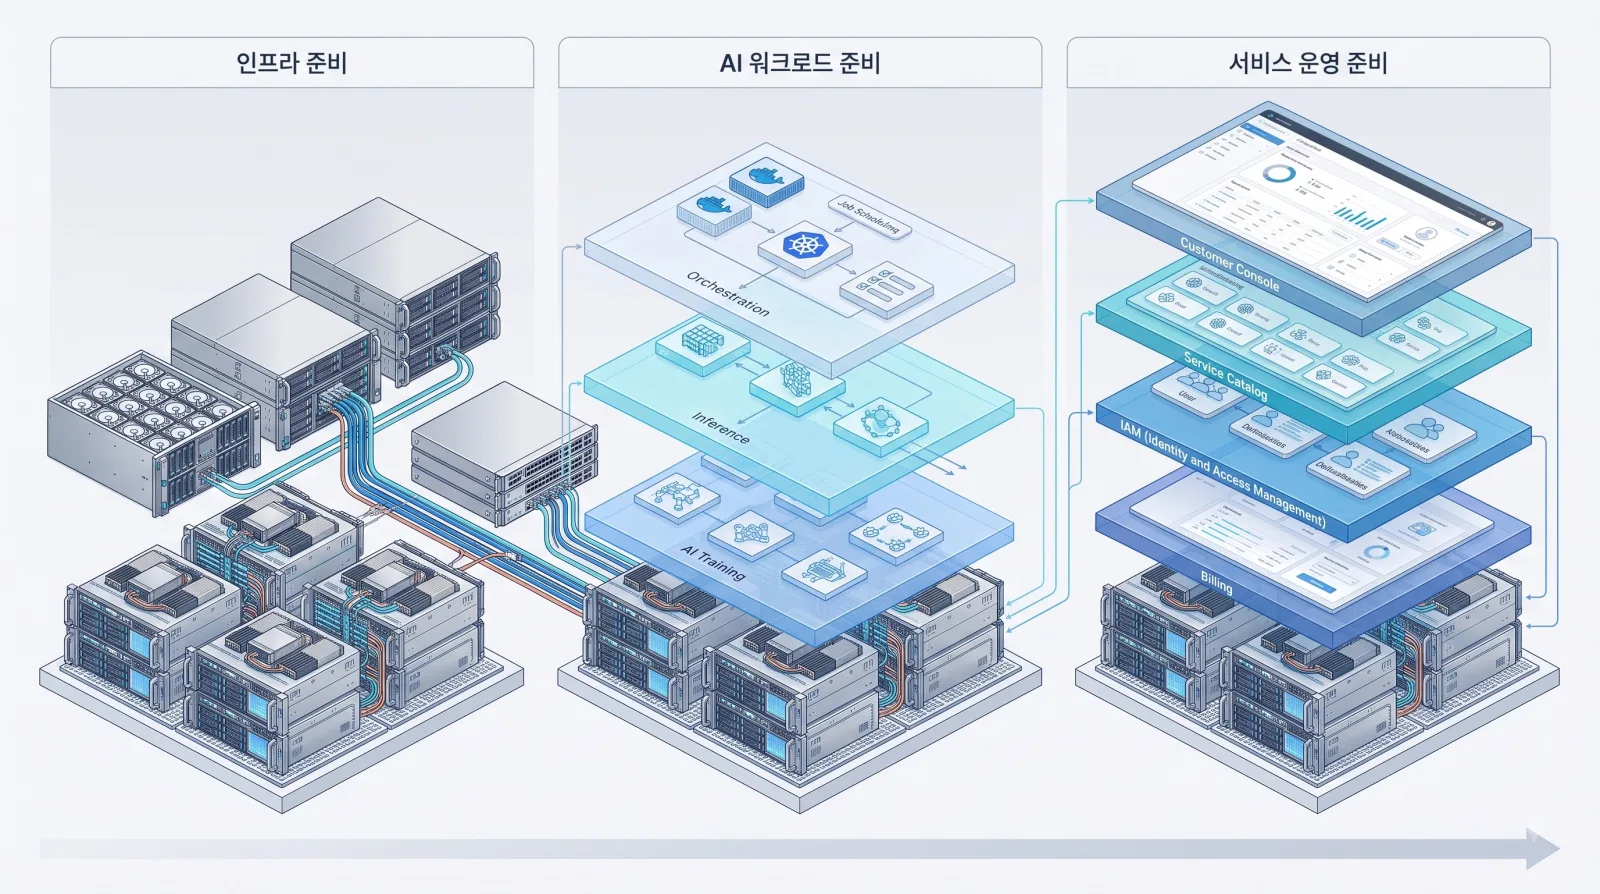
핵심은 하드웨어가 어느 순간 자동으로 “클라우드 상품”이 되는 것이 아니라는 점입니다.
기존 인프라 위에 상품화와 운영 계층이 추가되어야 비로소 서비스가 됩니다.
첫 고객에게 무엇을 판매할 것인가?
“GPU를 판매한다”는 표현만으로는 서비스가 정의되지 않습니다.
고객은 실제로 구매할 수 있는 상품이 필요합니다.
예를 들어 사업자는 다음과 같은 형태를 정의할 수 있습니다.
어떤 방식이 적합한지는 인프라와 사업 모델에 따라 달라집니다.
중요한 것은 각 상품에 다음 정보가 일관되게 연결되어 있어야 한다는 점입니다.
- GPU / 서버 사양
- 수량
- 사용 기간
- 예약 조건
- 가격 / 계약 조건
- 취소 조건
- 지원 범위
- 프로비저닝 기준
- 고객 이용 정책
GPU 재고 목록은 서비스 카탈로그와 다릅니다.
인프라 사양을 고객이 선택하고 구매할 수 있는 서비스 상품으로 바꾸는 과정이 필요합니다.
전용 GPU를 제공해도 멀티테넌시가 필요할까요?
그렇습니다.
멀티테넌시를 “여러 고객이 하나의 물리 GPU를 나눠 쓰는 것”으로만 이해하면 중요한 부분을 놓치게 됩니다.
고객 A에게 GPU 서버 8대를 전용으로 제공하고 고객 B에게 다른 GPU 서버를 제공하더라도 플랫폼은 여전히 다음을 구분해야 합니다.
- 고객 계정과 조직
- 사용자 권한과 인증 정보
- 네트워크
- 스토리지
- 접근 정책
- 할당량
- 사용 기록
- 서비스 상태
즉 전용 하드웨어는 GPU 자원의 전용성을 설명할 수 있지만, 고객 간 전체 경계를 대신하지는 않습니다.
테넌트 분리는 계정, 네트워크, 스토리지, 워크로드와 접근 권한 수준에서 실제로 검증되어야 합니다.
주문이 들어오면 어떤 일이 일어나야 할까요?
고객이 서비스를 선택한 뒤에는 주문이 실제 자원으로 연결되어야 합니다.
일반적인 흐름을 단순화하면 다음과 같습니다.
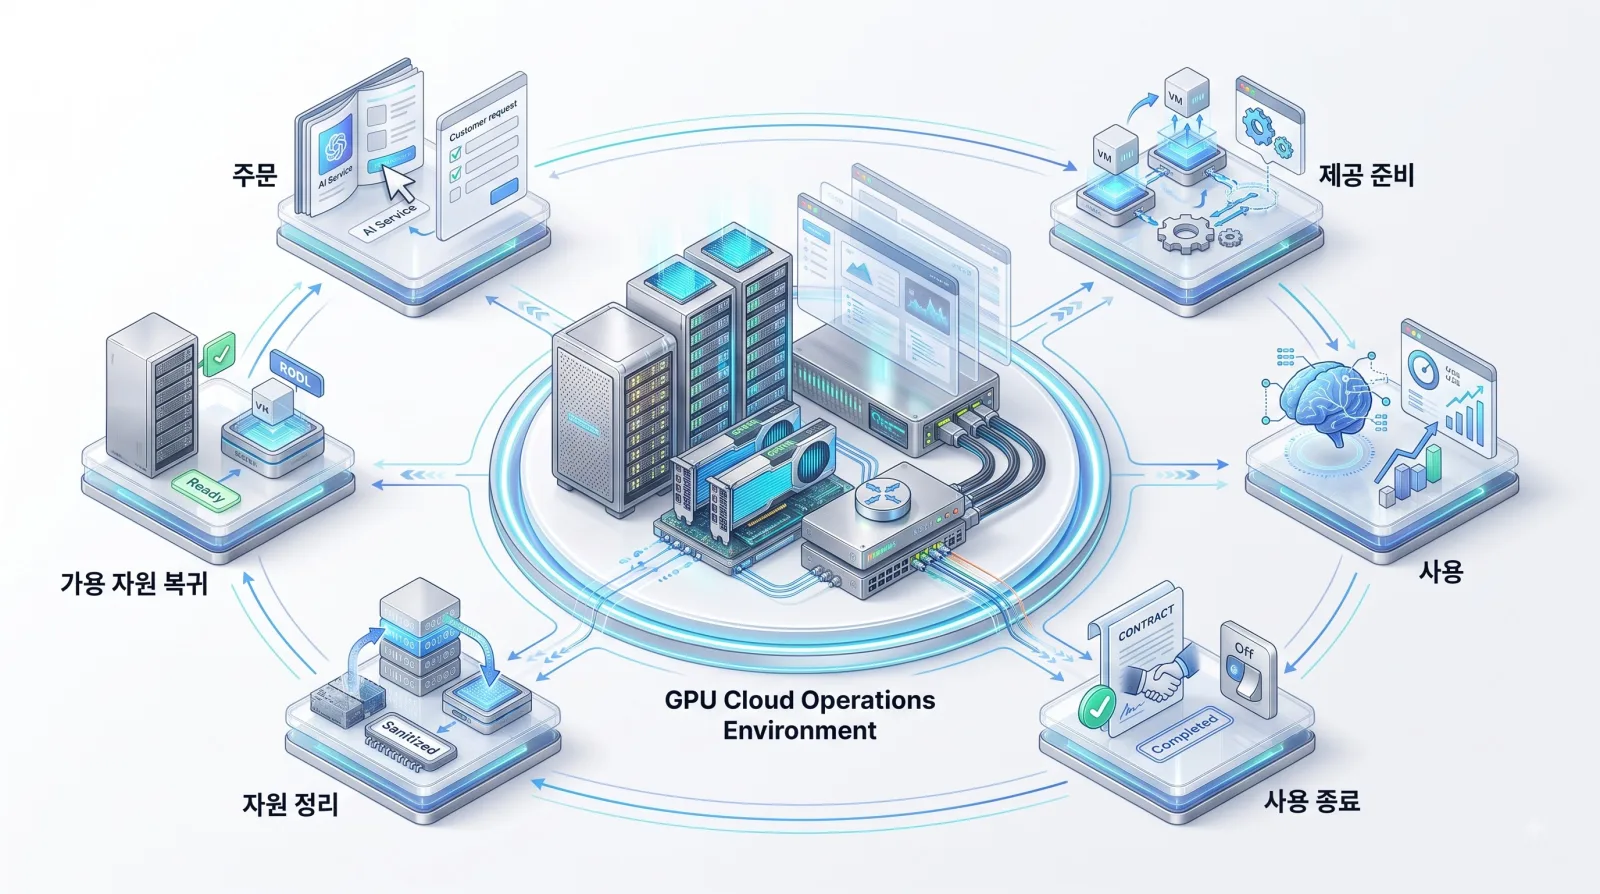
주문 → 권한 / 정책 확인 → 가용 용량 확인 및 예약 → 자원 할당 → 네트워크 / 스토리지 / 접근 구성 → 사용 가능
하지만 실제 서비스 운영에서는 정상적으로 끝나는 경우만 보면 부족합니다.
예를 들어:
- GPU 용량 예약에는 성공했는데 네트워크 프로비저닝이 실패하면?
- 고객이 중간에 취소하면?
- 일부 자원만 준비되면?
- 프로비저닝 재시도 중에는 과금이 시작되면 안 되는 경우라면?
- 장애 상태의 자원이 가용 용량으로 잘못 잡히면?
이런 상태를 사업자가 일관되게 추적하고 복구해야 합니다.
클라우드 서비스의 어려움은 “한 번 프로비저닝에 성공하는 것”이 아니라 반복되는 주문을 정상 상태와 실패 상태 모두에서 관리하는 것입니다.
사용량 측정과 과금은 같은 것이 아닙니다
GPU 클라우드에서 자주 생기는 혼동 중 하나는 GPU 모니터링 데이터가 곧 과금 데이터라고 생각하는 것입니다.
예를 들어 GPU 사용률이 0%인 시간도 고객이 전용 GPU를 예약하고 있다면 계약상 과금 대상일 수 있습니다.
반대로 GPU가 95% 사용률로 내부 테스트를 수행하고 있어도 고객 매출은 발생하지 않을 수 있습니다.
따라서 다음은 구분해야 합니다.
기술 모니터링 지표
GPU 코어, 메모리, 온도, 전력, 사용률 등 하드웨어와 워크로드 상태를 보여줍니다.
할당 / 예약 기록
어떤 고객에게 어떤 자원이 언제 할당되어 있었는지를 기록합니다.
과금 가능 사용 기록
계약과 서비스 정책에 따라 실제 과금 대상으로 인정되는 기록입니다.
단가 적용 / 과금 / 정산
과금 가능 기록에 가격과 계약 조건을 적용하고 청구 또는 정산 절차로 연결합니다.
GPU가 얼마나 바빴는가와 고객에게 무엇을 청구할 수 있는가는 같은 질문이 아닙니다.
이 구분이 없으면 사용량 보고서와 청구 내역이 서로 맞지 않는 문제가 생길 수 있습니다.
서비스 운영은 자원 생성으로 끝나지 않습니다
GPU 클라우드에서는 자원을 빠르게 프로비저닝하는 것이 중요합니다.
하지만 그 자원을 언제, 어떤 상태로 다시 가용 자원 풀에 돌려놓을 수 있는지도 중요합니다.
고객이 사용을 종료한 후에는 서비스 방식에 따라 다음 작업이 필요할 수 있습니다.
- 인증 정보 제거
- 네트워크 / 보안 정책 정리
- 스토리지 분리 / 데이터 처리
- OS / 이미지 초기화
- 서버 정리
- 하드웨어 상태 확인
- 사용 기록 종료
- 과금 상태 종료
- 가용 자원 풀 복귀
이 과정이 늦어지면 GPU는 물리적으로 존재하지만 다음 고객에게 판매할 수 없는 상태가 됩니다.
따라서 자원 회수와 재할당에 걸리는 시간도 실제 판매 가능 용량에 영향을 줄 수 있습니다.
GPU 클라우드 사업화 준비도 — 12개 실무 체크리스트
아래 체크리스트는 “GPU 클라우드 인증 기준”이 아닙니다.
사업자가 현재 인프라와 운영 방식의 빈틈을 찾기 위한 실무 진단표입니다.
A. 서비스 상품화
1. 서비스 사양
고객이 실제 구매할 수 있는 상품이 정의되어 있습니까?
GPU 종류와 수량뿐 아니라 베어메탈 / VM 여부, 스토리지, 네트워크, 사용 기간 같은 조건이 서비스 단위로 설명되어야 합니다.
2. 가격 / 계약 / 예약 정책
가격, 계약, 예약, 취소, 지원 조건이 일관되게 정의되어 있습니까?
영업이 약속한 내용과 운영 플랫폼이 실행하는 정책이 서로 달라서는 안 됩니다.
3. 주문 / 서비스 상태 관리
주문이 들어온 뒤 현재 상태를 추적할 수 있습니까?
예: 주문 → 예약 → 프로비저닝 → 사용 가능 → 사용 중 → 종료 중 → 완료
실패 / 취소 / 재시도 상태도 운영 가능해야 합니다.
B. 고객과 자원
4. 조직 / IAM / 할당량
고객 조직, 사용자, 역할, 인증 정보, 할당량을 독립적으로 관리할 수 있습니까?
한 고객의 권한이 다른 고객의 자원으로 확장되지 않아야 합니다.
5. 검증된 테넌트 분리
계정, 네트워크, 스토리지, 워크로드와 접근 권한 경계가 실제로 검증되어 있습니까?
전용 GPU를 제공하더라도 이 항목은 필요할 수 있습니다.
6. 자원 할당 / 프로비저닝 상태
GPU, 컴퓨팅, 네트워크, 스토리지, 이미지 / 런타임, 접근 권한의 실제 준비 상태가 하나의 서비스 상태와 연결되어 있습니까?
“서버 할당 완료”와 “고객 사용 가능”은 다를 수 있습니다.
C. 과금과 운영
7. 과금 가능 사용 기록
기술 모니터링과 별도로 계약과 연결할 수 있는 과금 가능 기록을 만들 수 있습니까?
예약 기간, 할당 기간, 서비스 요금제와 과금 정책이 연결되어야 합니다.
8. 과금 / 정산 정확성
사용 기록, 단가 적용, 청구 / 정산, 조정, 취소가 일관되게 처리됩니까?
프로비저닝 실패가 발생했을 때 잘못된 과금이 시작되지 않도록 서비스 상태와 과금 상태가 연결되어야 합니다.
9. 장애 / 가용 용량 / SLA 운영
장애, 유지보수, 가용 용량, 예약, 고객 서비스 수준 약속을 운영할 수 있습니까?
고객용 서비스에서는 인프라 상태뿐 아니라 서비스 상태와 고객 안내도 중요합니다.
D. 자원 라이프사이클과 확장
10. 반복 가능한 운영 절차
주문, 프로비저닝, 실패 재시도 / 롤백, 지원, 종료 절차가 특정 엔지니어의 경험에 의존하지 않고 반복 가능합니까?
11. 종료 / 초기화 / 재할당
고객 사용 종료 후 자원을 안전하게 정리하고 다시 가용 자원 풀로 되돌릴 수 있습니까?
데이터 처리와 접근 권한 회수도 함께 확인해야 합니다.
12. 신규 장비 / SKU 확장
새로운 GPU 모델, 서버, 데이터센터, 서비스 SKU를 추가할 때 전체 시스템을 다시 만들지 않고 기존 운영 방식에 확장할 수 있습니까?
하드웨어 재고가 늘어날수록 카탈로그, 정책, 프로비저닝, 사용량 측정과 운영 체계도 함께 확장되어야 합니다.
체크리스트 점수가 높으면 서비스 준비가 끝난 걸까요?
반드시 그렇지는 않습니다.
예를 들어 12개 중 10개가 준비되어 있어도 다음 중 하나가 검증되지 않았다면 심각한 위험이 남을 수 있습니다.
- 테넌트 분리
- 고객 데이터 처리
- 과금 정확성
- 접근 권한 회수
- 실패 복구
따라서 이 체크리스트를 단순 점수표로 사용하는 것은 권장하지 않습니다.
먼저 핵심 통제가 안전하게 동작하는지, 그 다음 전체 운영 흐름이 반복 가능한지 봐야 합니다.
Thaki Cloud는 이 문제를 어떻게 볼까요?
Thaki Cloud의 NeoCloud 구조는 다음과 같이 설명할 수 있습니다.
고객 인프라 → Thaki NeoCloud OS → 고객 NeoCloud 서비스
인프라 보유 사업자가 자신의 GPU / AI 인프라를 유지하고, Thaki NeoCloud OS가 그 인프라와 고객용 서비스 사이의 클라우드 운영 계층 역할을 합니다.
프로젝트와 환경에 따라 실제 지원 범위는 확인이 필요하지만, 현재 기능 모델은 서비스 카탈로그, 주문 / 제공, 사용자 / 조직 관리, 멀티테넌시, 프로비저닝, 스케줄링, 사용량 측정, 과금 / 정산 연동, SLA, 관측, 용량 관리와 라이프사이클 자동화 같은 영역을 다룹니다.
중요한 점은 Thaki Cloud가 사업자의 GPU를 대신 임대하는 구조가 아니라는 것입니다.
목표는 인프라 보유 사업자가 자신의 브랜드, 서비스 정책과 사업 모델로 클라우드 서비스를 운영할 수 있게 하는 것입니다.
정리하면
GPU 클라우드 사업화 준비도를 판단할 때 첫 질문은 “GPU가 몇 개 있는가?”가 아닙니다.
더 중요한 질문은:
고객이 내일 주문해도 서비스를 정확하게 만들고, 분리하고, 측정하고, 청구하고, 종료한 뒤 다시 판매 가능한 상태로 돌릴 수 있는가?
입니다.
인프라 준비와 서비스 운영 준비 사이에는 상품화와 운영이라는 큰 차이가 있습니다.
12개 체크리스트는 그 차이를 찾기 위한 출발점입니다.
FAQ
GPU 서버가 이미 운영 중이면 GPU 클라우드 사업을 바로 시작할 수 있나요?
가능 여부는 하드웨어보다 서비스 운영 방식에 달려 있습니다. 고객용 상품, 주문, 테넌트 분리, 프로비저닝, 사용량 측정, 과금, 지원과 자원 라이프사이클이 반복 가능하게 연결되어야 합니다.
전용 베어메탈만 제공하면 멀티테넌시가 필요 없나요?
그렇지 않을 수 있습니다. 물리 GPU를 공유하지 않더라도 고객 계정, 네트워크, 스토리지, 인증 정보, 정책과 사용 기록은 분리해야 합니다.
GPU 사용률을 과금 데이터로 사용하면 안 되나요?
기술적 사용률은 중요한 운영 데이터지만 과금 가능 사용 기록과 동일하지 않습니다. 실제 과금은 할당 / 예약, 계약, 단가, 서비스 상태 같은 상업적 맥락이 필요합니다.
프로비저닝이 빠르면 서비스 준비가 끝났다고 볼 수 있나요?
프로비저닝은 핵심 기능 중 하나입니다. 하지만 주문 관리, 테넌트 분리, 사용량 측정, 과금, 실패 복구, 종료와 자원 재할당까지 연결되어야 전체 서비스 라이프사이클이 완성됩니다.
이 12개 체크리스트는 공식 인증 기준인가요?
아닙니다. GPU 클라우드 사업화의 빈틈을 찾기 위한 실무 진단표입니다.
GPU 클라우드 사업화 준비도를 함께 검토하시겠습니까?
GPU 인프라는 이미 있지만 고객용 서비스로 전환할 때 어떤 부분이 남아 있는지 점검하고 있다면, Thaki Cloud와 아키텍처와 사업화 준비도를 함께 검토해 보세요.
문의하기참고 자료
관련 아티클
- GPU Cloud란 무엇인가? 개념, 작동 방식, GPUaaS와의 차이GPU Cloud는 데이터센터의 GPU를 네트워크를 통해 필요할 때 사용하는 클라우드 컴퓨팅 방식입니다. GPUaaS와의 차이, 작동 방식, Bare Metal·Virtual GPU 유형, 활용 사례와 운영 구조를 설명합니다.
- AI Factory란 무엇인가? AI 데이터센터와 무엇이 다른가?AI Factory는 AI 워크로드를 반복적으로 개발·학습·배포·운영하기 위한 통합 인프라와 운영 환경입니다. AI 데이터센터와의 차이, 핵심 구성 요소, AI Lifecycle, GPU Cloud와의 관계를 설명합니다.
- GPUaaS란 무엇인가? GPU as a Service의 구조와 핵심 기능GPUaaS는 GPU 연산 자원을 직접 구매하지 않고 서비스 형태로 사용하는 방식입니다. GPU Cloud와의 차이, 작동 방식, Bare Metal·Virtual GPU 제공 형태, 운영 기능과 선택 기준을 설명합니다.
- Private AI Cloud란 무엇인가?Private AI Cloud는 단일 조직 전용의 Private Cloud 운영 모델에 GPU·AI 플랫폼·데이터·보안·거버넌스를 결합한 AI 환경입니다. Public AI Cloud, On-Prem AI, Sovereign AI, Air-Gapped AI와의 차이와 구축 고려사항을 설명합니다.
- GPU 서버가 있다고 GPU Cloud가 되는 것은 아닙니다GPU 서버를 보유하거나 호스팅한다고 자동으로 GPU Cloud가 되는 것은 아닙니다. GPU Hosting과 GPU Cloud의 차이, Self-Service·Provisioning·Scheduling·Metering 등 Cloud 운영에 필요한 핵심 기능을 설명합니다.
- NeoCloud란 무엇인가? AI 시대의 GPU 중심 클라우드NeoCloud는 GPU와 AI Workload에 특화된 Cloud Infrastructure Provider를 설명할 때 사용되는 산업 용어입니다. 기존 Hyperscaler, GPU Cloud, GPUaaS와의 관계와 Thaki Cloud의 NeoCloud Enablement 관점을 설명합니다.
- AI Factory의 다음 단계는 Cloud Service입니다AI Factory를 구축하는 것과 고객이 실제로 사용할 수 있는 Cloud Service를 운영하는 것은 다릅니다. Provisioning, Multi-Tenancy, GPU Scheduling, Metering, Billing, SLA 등 서비스화에 필요한 운영 계층을 설명합니다.
- AI 인프라를 Cloud Business로 전환한다는 것은 무엇인가?GPU와 AI 인프라를 보유하는 것과 실제 Cloud Business를 운영하는 것은 다릅니다. Infrastructure → Product → On-demand Cloud Service 전환 과정과 Service Catalog, Provisioning, Metering, Billing, SLA 등 사업화에 필요한 운영 구조를 설명합니다.
- Bare Metal GPU란? 가상화 GPU와의 차이와 활용 방식Bare Metal GPU의 개념과 GPU VM, vGPU, GPU Passthrough의 차이를 알아보세요. 전용성, 성능 일관성, 유연성, 자원 효율, Provisioning 관점에서 어떤 방식이 적합한지 설명합니다.
- Private AI Cloud와 Public AI Cloud의 차이Private AI Cloud와 Public AI Cloud를 전용성, 통제 범위, 확장성, Managed Service, 운영 책임, 비용 구조 관점에서 비교합니다. 어떤 AI Workload에 각각 적합한지 알아보세요.
- GPU Scheduling이란? AI Cloud에서 GPU 자원을 배분하는 방법GPU Scheduling의 개념과 Queue, Priority, Quota, GPU Type, Topology, Multi-GPU Job, Resource Fragmentation을 알아보세요. GPU Cloud에서 Scheduling과 Provisioning이 어떻게 다른지도 설명합니다.
- AI Factory 구축 이후에 필요한 운영 플랫폼은 무엇인가?AI Factory 구축 이후 실제 운영 단계에서 필요한 Provisioning, GPU Scheduling, 사용자·Policy 관리, Observability, Capacity Management, Metering과 Lifecycle Automation을 알아보세요.
- On-Prem AI란? 기업이 자체 환경에서 AI를 운영하는 이유On-Prem AI의 개념과 Private AI Cloud와의 차이, 기업이 데이터·모델·네트워크·지연시간·운영 통제를 이유로 자체 환경에서 AI를 운영하는 경우와 Trade-off를 알아보세요.
- GPU Multi-Tenancy란? 여러 고객이 GPU 인프라를 안전하게 사용하는 구조GPU Multi-Tenancy의 개념과 Tenant Isolation, Dedicated GPU, vGPU, MIG, Kubernetes Namespace, Quota, Scheduling, Network·Storage 분리와 Usage 관리 구조를 알아보세요.
- GPU Provisioning이란? 주문에서 사용 가능 상태까지의 자동화GPU Provisioning의 개념과 GPU 요청 이후 Compute, Network, Storage, Image, Runtime, Access를 준비해 실제 사용 가능한 환경으로 만드는 자동화 과정을 알아보세요.
- AI Factory를 Multi-Customer Cloud Service로 전환하려면AI Factory를 여러 고객이 사용하는 Cloud Service로 전환할 때 필요한 Service Catalog, Multi-Tenancy, Provisioning, Scheduling, Metering, Billing, SLA와 Lifecycle을 알아보세요.
- GPU 클라우드 수익성 분석: 가동률보다 중요한 것은 무엇일까?GPU 사용률과 과금 가능 시간은 같은 지표가 아닙니다. 가상의 32-GPU 계산 예시를 통해 판매 가능 용량, 과금 가능 GPU 시간, 실현 단가, 고정비·변동비와 손익분기점을 설명합니다.
- GPU 클라우드 직접 구축 vs. 통합 운영 플랫폼: 무엇이 더 합리적일까?OpenStack, Kubernetes, Prometheus 같은 오픈소스로 GPU 클라우드를 구축할 수 있습니다. 직접 통합과 운영 플랫폼 도입을 연동, 실패 처리, 과금, 확장성과 3–5년 총소유비용 관점에서 비교합니다.