Air-Gapped AI란? 망분리 환경에서 AI를 운영하는 방식
“인터넷이 안 되는 환경에서 AI를 돌린다.”
Air-Gapped AI를 가장 간단하게 설명하면 이렇게 들릴 수 있습니다.
하지만 실제 Air Gap은 일반적인 Firewall이나 Private Network보다 훨씬 강한 분리 개념입니다.
NIST CSRC Glossary의 정의에 따르면 Air Gap은 두 System 사이에 물리적 연결이 없고, 자동화된 Logical Connection도 없으며, Interface를 통한 Data Transfer는 사람이 통제하는 Manual Process로 이루어지는 경계를 의미합니다.
즉:
Air-Gapped AI의 핵심은 인터넷 차단이 아니라 “외부 System과 자동 연결되지 않는 운영 환경”입니다.
AI에서는 이 차이가 특히 중요합니다.
왜냐하면 Model, Dataset, Container Image, Python Package, Driver, Security Patch와 Monitoring Tool까지 평소에는 외부 Repository와 API에 의존하는 경우가 많기 때문입니다.
인터넷이 막혀 있으면 모두 Air-Gapped 환경일까요?
그렇지 않습니다.
다음은 서로 다른 개념입니다.
Private Network
외부에 공개되지 않은 Network일 수 있지만 다른 Network나 Internet과 Gateway / Proxy / VPN을 통해 연결될 수 있습니다.
Network Segmentation
하나의 더 큰 Network 안에서 Zone이나 Segment를 나누고 Firewall / ACL 등으로 Traffic을 제한합니다.
Restricted Network
외부 연결을 강하게 제한하지만 일부 승인된 Outbound / Inbound Connection이 존재할 수 있습니다.
Air Gap
물리적 연결도 없고 자동화된 Logical Connection도 없습니다.
Data Transfer가 필요하면 조직이 정의한 Controlled Manual Process가 필요합니다.
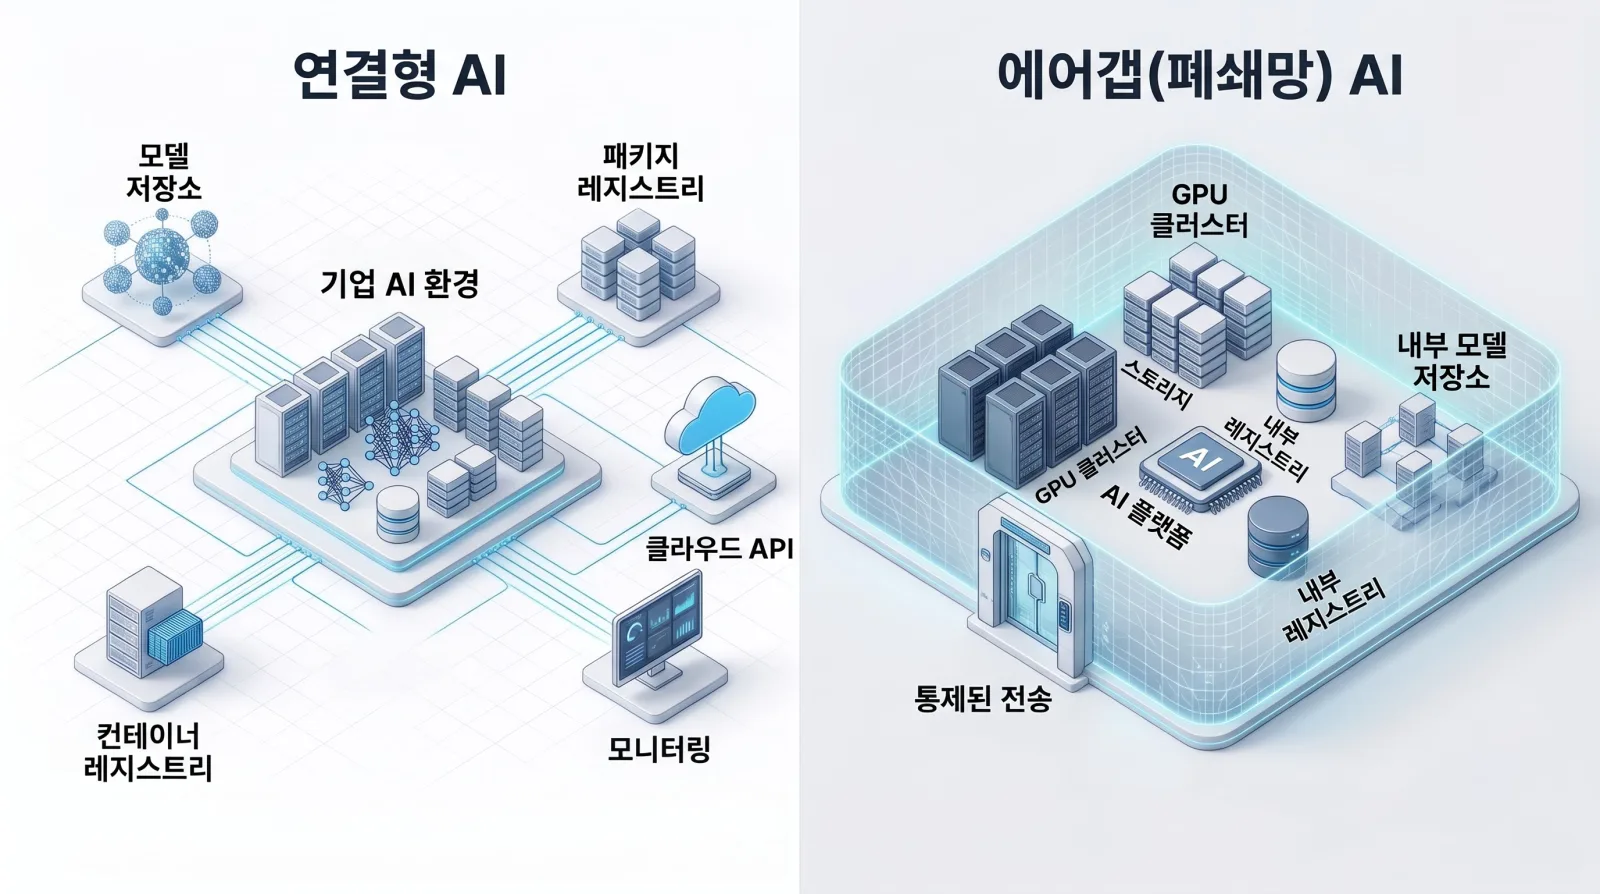
따라서 “망분리”라는 한국어 표현과 Air Gap을 항상 같은 것으로 사용해서는 안 됩니다.
망분리는 제도와 구현 방식에 따라 Physical Separation, Logical Separation, Restricted Access 등 여러 구조를 포함할 수 있습니다.
AI에서는 왜 Air Gap 운영이 더 어려울까요?
일반 Application도 Air-Gapped 환경에서 운영하기 어렵습니다.
AI는 여기에 더 많은 Artifact와 Dependency가 추가됩니다.
예를 들어 Model 하나를 운영하려고 해도 다음이 필요할 수 있습니다.
- Model Weight
- Tokenizer
- Runtime
- Python Package
- Container Image
- GPU Driver
- CUDA / Accelerator Runtime
- Evaluation Dataset
- Prompt / Template
- Embedding Model
- Vector Index
- Security Patch
Connected Environment에서는 이런 요소를 Online Registry나 Repository에서 가져올 수 있습니다.
Air-Gapped 환경에서는 그렇지 않습니다.
따라서:
“AI를 설치하는 방법”보다 “AI Artifact를 어떤 절차로 반입하고 업데이트하고 검증할 것인가”가 중요해집니다.
AI에서는 무엇을 반입해야 할까요?
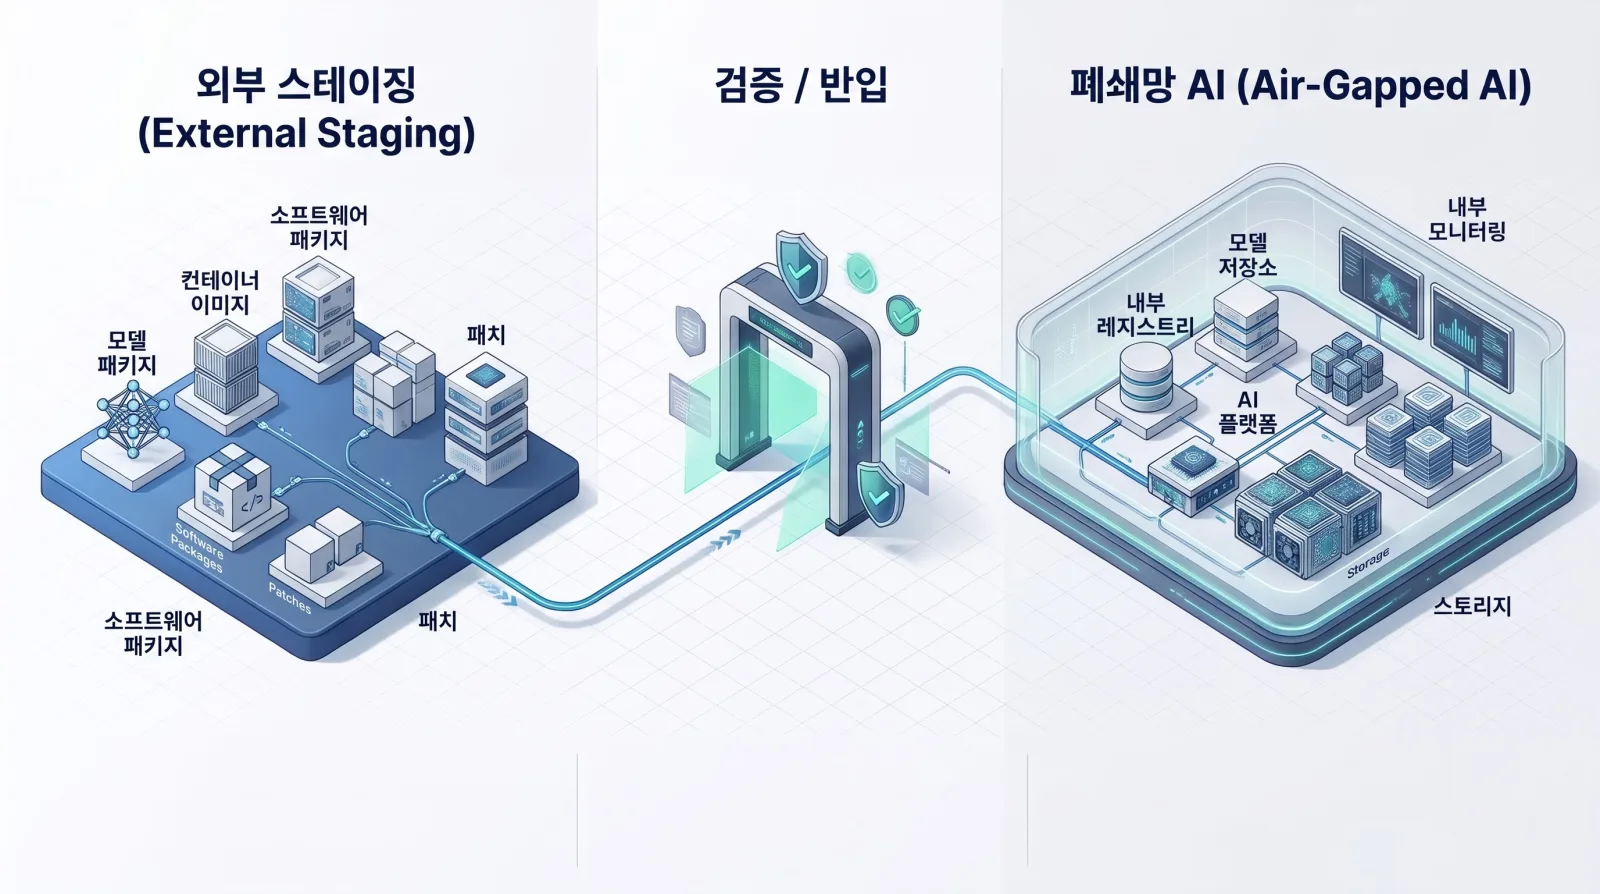
Air-Gapped AI에서는 Software Lifecycle 자체가 달라집니다.
Model
Foundation Model이나 Fine-tuned Model Weight를 내부 Repository로 반입해야 할 수 있습니다.
Version, Source, Hash, License, Approval Status를 관리하는 절차가 필요할 수 있습니다.
Dataset
Training / Fine-tuning / Evaluation Data를 반입한다면 Data Classification과 승인 절차가 필요합니다.
Package / Container Image
Online Package Repository에 접근할 수 없기 때문에 필요한 Package와 Container Image를 내부 Registry에 준비해야 합니다.
GPU Driver / Runtime
GPU Driver, CUDA / Accelerator Runtime, Firmware 등도 외부에서 자동 Update되지 않을 수 있습니다.
Security Update
Vulnerability가 발견되어도 Internet-connected Server처럼 즉시 Patch Repository에 접근할 수 없습니다.
Patch를 외부 Staging Environment에서 확보하고 검증한 뒤 내부로 반입하는 별도 절차가 필요합니다.
Offline Registry와 Repository가 중요해집니다
Connected AI Platform에서는:
- Container Registry
- Package Repository
- Model Hub
- Git Repository
같은 외부 Service에 자연스럽게 의존할 수 있습니다.
Air-Gapped 환경에서는 필요한 Artifact를 내부에 복제하거나 별도 Repository를 운영해야 할 수 있습니다.
예:
- Internal Container Registry
- Internal Package Repository
- Model Repository
- Dataset Storage
- Internal Git / Source Repository
중요한 것은 단순히 File을 복사해 두는 것이 아니라:
어떤 Version이 승인되었고 현재 Production에서 사용 중인지 추적할 수 있어야 한다는 점
입니다.
Model Update는 어떻게 할까요?
Connected Environment에서는 새로운 Model Version을 자동 Download할 수도 있습니다.
Air-Gapped Environment에서는 Update가 하나의 Change Management Process가 됩니다.
예를 들어:
- 외부 Staging 환경에서 Model 확보
- Source / License / Integrity 확인
- Security Scan
- Evaluation
- 승인
- Controlled Transfer
- 내부 Model Registry 등록
- Deployment
- Rollback 가능 여부 확인
같은 과정이 필요할 수 있습니다.
조직마다 절차는 다릅니다.
중요한 것은 Air Gap에서는 “Update”가 단순 Download가 아니라 Controlled Supply Chain 문제라는 것입니다.
RAG도 달라집니다
RAG는 외부 LLM API를 호출하지 않으면 끝나는 문제가 아닙니다.
Air-Gapped RAG에서는:
- Embedding Model
- Vector Database
- Document Parser
- OCR
- Indexing Pipeline
- Model Serving
이 모두 내부에서 운영되어야 할 수 있습니다.
새로운 Document를 반입하는 절차도 필요합니다.
즉 RAG Pipeline 전체가 Air-Gapped Boundary 안에서 완결되어야 합니다.
AI Agent는 더 복잡할 수 있습니다
Agent는 Tool이나 외부 API를 호출하는 경우가 많습니다.
예:
- Search
- SaaS API
- ERP
- External Database
- Public Web
Air-Gapped 환경에서는 이런 Tool Access가 제한됩니다.
따라서 Agent를 운영하려면:
- 내부 Tool만 허용
- 내부 API Gateway
- Approved Data Source
- Controlled Action
같은 별도 설계가 필요할 수 있습니다.
일반 Internet Agent를 그대로 가져와 사용하는 방식과는 다릅니다.
Monitoring과 Observability도 내부에서 완결되어야 합니다
외부 SaaS Monitoring이나 Cloud Logging을 사용할 수 없다면:
- Metrics
- Log
- Alert
- Trace
- GPU Monitoring
을 내부 System에서 수집하고 저장해야 합니다.
운영팀이 외부에서 원격 Support를 할 수 없는 경우 내부 Operator와 Support Process도 중요해집니다.
Air Gap은 “자동으로 더 안전하다”는 뜻일까요?
Air Gap은 Attack Surface와 Connectivity를 줄이는 강력한 Control이 될 수 있습니다.
하지만 완전한 Security Guarantee는 아닙니다.
위험은 다른 형태로 이동합니다.
예:
- 반입 Media
- Supply Chain
- Insider
- 승인되지 않은 Artifact
- Patch 지연
- Credential
- Physical Access
- Misconfiguration
따라서 Air Gap 환경에서도 Governance, Access Control, Artifact Verification, Audit과 Operations가 필요합니다.
Availability와 Recovery도 고려해야 합니다
외부 Network가 없으면 장애 시 Cloud Service나 Vendor Support를 즉시 사용할 수 없을 수 있습니다.
따라서:
- Local Backup
- Spare Capacity
- Internal Documentation
- Recovery Image
- Offline Package
- Local Expertise
같은 운영 준비가 더 중요해질 수 있습니다.
Air Gap은 Security Architecture인 동시에 Operational Self-Sufficiency 요구이기도 합니다.
Air-Gapped AI, On-Prem AI, Private AI Cloud는 같은가요?
아닙니다.
On-Prem AI
AI가 Customer / Organization 자체 환경에 배포되는 Location / Deployment 개념입니다.
Private AI Cloud
특정 Organization을 위한 Cloud Operating Model입니다.
Air-Gapped AI
외부 System과 자동 연결이 없는 Connectivity / Transfer Boundary입니다.
따라서 On-Prem이면서 Air-Gapped일 수 있고, Private AI Cloud가 Air-Gapped 환경에 구축될 수도 있습니다.
하지만 모든 On-Prem / Private AI가 Air-Gapped인 것은 아닙니다.
Sovereign AI와도 같은 개념은 아닙니다
Air Gap은 Connectivity Control입니다.
Sovereign AI는 Data, Access, Key, Infrastructure, Operations, Jurisdiction 등 더 넓은 Control Scope를 다룹니다.
어떤 Sovereign AI Workload가 Air-Gapped Architecture를 요구할 수는 있지만, 둘은 동일한 개념이 아닙니다.
Thaki Cloud는 이 문제를 어떻게 볼까요?
외부 연결이 제한된 기업이나 기관에서는 GPU Hardware뿐 아니라 AI Software Supply Chain과 운영 방식까지 함께 설계해야 합니다.
Thaki Cloud의 On-Premise Solutions와 Private / On-Prem AI 방향은 Customer-owned Infrastructure 위에서 AI Platform과 Workload를 운영하는 시나리오를 다룹니다.
다만 특정 Air-Gapped Deployment의 지원 범위와 필요한 Integration은 실제 Customer Environment 기준으로 확인해야 합니다.
정리하면
Air-Gapped AI는 단순히 Internet Cable을 뽑는 것이 아닙니다.
핵심은:
Model + Data + Package + Runtime + Patch + Operations
의 전체 Lifecycle이 외부 자동 연결 없이 운영될 수 있도록 만드는 것입니다.
따라서 Air-Gapped AI의 어려움은 GPU 성능보다:
AI Software와 Artifact의 반입, 검증, 배포, Update와 운영을 어떻게 지속 가능하게 만들 것인가?
에 있습니다.
FAQ
Internet이 차단되어 있으면 Air-Gapped 환경인가요?
반드시 그렇지는 않습니다. 다른 Network와 자동화된 Logical Connection이 존재한다면 NIST 의미의 Air Gap과 다를 수 있습니다.
망분리와 Air Gap은 같은가요?
항상 같지는 않습니다. 망분리는 다양한 Physical / Logical 분리 방식을 포함할 수 있습니다.
Air-Gapped 환경에서도 LLM을 운영할 수 있나요?
가능합니다. 다만 Model, Runtime, Package와 Update를 내부에서 운영할 수 있는 구조가 필요합니다.
Air-Gapped RAG도 가능한가요?
가능합니다. Embedding, Vector DB, Parsing과 Model Serving Pipeline을 내부에서 완결해야 할 수 있습니다.
Air Gap이면 보안 문제가 사라지나요?
아닙니다. Supply Chain, Artifact Transfer, Insider, Patch Delay와 Physical Security 같은 다른 Risk가 남습니다.
Air-Gapped AI Environment를 검토하고 계신가요?
외부 연결이 제한된 환경에서 GPU, AI Platform, Model / Data Lifecycle과 운영 체계를 함께 설계하고 있다면 Thaki Cloud와 Private / On-Prem AI Architecture를 검토해 보세요.
문의하기참고 자료
관련 아티클
- GPU Cloud란 무엇인가? 개념, 작동 방식, GPUaaS와의 차이GPU Cloud는 데이터센터의 GPU를 네트워크를 통해 필요할 때 사용하는 클라우드 컴퓨팅 방식입니다. GPUaaS와의 차이, 작동 방식, Bare Metal·Virtual GPU 유형, 활용 사례와 운영 구조를 설명합니다.
- AI Factory란 무엇인가? AI 데이터센터와 무엇이 다른가?AI Factory는 AI 워크로드를 반복적으로 개발·학습·배포·운영하기 위한 통합 인프라와 운영 환경입니다. AI 데이터센터와의 차이, 핵심 구성 요소, AI Lifecycle, GPU Cloud와의 관계를 설명합니다.
- GPUaaS란 무엇인가? GPU as a Service의 구조와 핵심 기능GPUaaS는 GPU 연산 자원을 직접 구매하지 않고 서비스 형태로 사용하는 방식입니다. GPU Cloud와의 차이, 작동 방식, Bare Metal·Virtual GPU 제공 형태, 운영 기능과 선택 기준을 설명합니다.
- Private AI Cloud란 무엇인가?Private AI Cloud는 단일 조직 전용의 Private Cloud 운영 모델에 GPU·AI 플랫폼·데이터·보안·거버넌스를 결합한 AI 환경입니다. Public AI Cloud, On-Prem AI, Sovereign AI, Air-Gapped AI와의 차이와 구축 고려사항을 설명합니다.
- GPU 서버가 있다고 GPU Cloud가 되는 것은 아닙니다GPU 서버를 보유하거나 호스팅한다고 자동으로 GPU Cloud가 되는 것은 아닙니다. GPU Hosting과 GPU Cloud의 차이, Self-Service·Provisioning·Scheduling·Metering 등 Cloud 운영에 필요한 핵심 기능을 설명합니다.
- NeoCloud란 무엇인가? AI 시대의 GPU 중심 클라우드NeoCloud는 GPU와 AI Workload에 특화된 Cloud Infrastructure Provider를 설명할 때 사용되는 산업 용어입니다. 기존 Hyperscaler, GPU Cloud, GPUaaS와의 관계와 Thaki Cloud의 NeoCloud Enablement 관점을 설명합니다.
- AI Factory의 다음 단계는 Cloud Service입니다AI Factory를 구축하는 것과 고객이 실제로 사용할 수 있는 Cloud Service를 운영하는 것은 다릅니다. Provisioning, Multi-Tenancy, GPU Scheduling, Metering, Billing, SLA 등 서비스화에 필요한 운영 계층을 설명합니다.
- AI 인프라를 Cloud Business로 전환한다는 것은 무엇인가?GPU와 AI 인프라를 보유하는 것과 실제 Cloud Business를 운영하는 것은 다릅니다. Infrastructure → Product → On-demand Cloud Service 전환 과정과 Service Catalog, Provisioning, Metering, Billing, SLA 등 사업화에 필요한 운영 구조를 설명합니다.
- Bare Metal GPU란? 가상화 GPU와의 차이와 활용 방식Bare Metal GPU의 개념과 GPU VM, vGPU, GPU Passthrough의 차이를 알아보세요. 전용성, 성능 일관성, 유연성, 자원 효율, Provisioning 관점에서 어떤 방식이 적합한지 설명합니다.
- Private AI Cloud와 Public AI Cloud의 차이Private AI Cloud와 Public AI Cloud를 전용성, 통제 범위, 확장성, Managed Service, 운영 책임, 비용 구조 관점에서 비교합니다. 어떤 AI Workload에 각각 적합한지 알아보세요.
- GPU Scheduling이란? AI Cloud에서 GPU 자원을 배분하는 방법GPU Scheduling의 개념과 Queue, Priority, Quota, GPU Type, Topology, Multi-GPU Job, Resource Fragmentation을 알아보세요. GPU Cloud에서 Scheduling과 Provisioning이 어떻게 다른지도 설명합니다.
- AI Factory 구축 이후에 필요한 운영 플랫폼은 무엇인가?AI Factory 구축 이후 실제 운영 단계에서 필요한 Provisioning, GPU Scheduling, 사용자·Policy 관리, Observability, Capacity Management, Metering과 Lifecycle Automation을 알아보세요.
- On-Prem AI란? 기업이 자체 환경에서 AI를 운영하는 이유On-Prem AI의 개념과 Private AI Cloud와의 차이, 기업이 데이터·모델·네트워크·지연시간·운영 통제를 이유로 자체 환경에서 AI를 운영하는 경우와 Trade-off를 알아보세요.
- GPU Multi-Tenancy란? 여러 고객이 GPU 인프라를 안전하게 사용하는 구조GPU Multi-Tenancy의 개념과 Tenant Isolation, Dedicated GPU, vGPU, MIG, Kubernetes Namespace, Quota, Scheduling, Network·Storage 분리와 Usage 관리 구조를 알아보세요.
- GPU Provisioning이란? 주문에서 사용 가능 상태까지의 자동화GPU Provisioning의 개념과 GPU 요청 이후 Compute, Network, Storage, Image, Runtime, Access를 준비해 실제 사용 가능한 환경으로 만드는 자동화 과정을 알아보세요.
- AI Factory를 Multi-Customer Cloud Service로 전환하려면AI Factory를 여러 고객이 사용하는 Cloud Service로 전환할 때 필요한 Service Catalog, Multi-Tenancy, Provisioning, Scheduling, Metering, Billing, SLA와 Lifecycle을 알아보세요.
- GPU 클라우드 사업화 준비도 체크리스트: 무엇을 점검해야 할까?GPU 서버를 보유했다고 바로 GPU 클라우드 서비스를 판매할 수 있는 것은 아닙니다. 서비스 상품화, 멀티테넌시, 프로비저닝, 사용량 측정, 과금, SLA와 자원 라이프사이클을 12개 실무 항목으로 점검합니다.
- GPU 클라우드 수익성 분석: 가동률보다 중요한 것은 무엇일까?GPU 사용률과 과금 가능 시간은 같은 지표가 아닙니다. 가상의 32-GPU 계산 예시를 통해 판매 가능 용량, 과금 가능 GPU 시간, 실현 단가, 고정비·변동비와 손익분기점을 설명합니다.
- GPU 클라우드 직접 구축 vs. 통합 운영 플랫폼: 무엇이 더 합리적일까?OpenStack, Kubernetes, Prometheus 같은 오픈소스로 GPU 클라우드를 구축할 수 있습니다. 직접 통합과 운영 플랫폼 도입을 연동, 실패 처리, 과금, 확장성과 3–5년 총소유비용 관점에서 비교합니다.
- Self-Service Cloud란? 고객이 직접 주문하고 사용하는 클라우드 서비스셀프서비스 클라우드는 단순한 포털이 아닙니다. 서비스 카탈로그, IAM, 정책·할당량, 가용 용량, 프로비저닝, 사용량 측정과 자원 회수가 어떻게 연결되어야 하는지 설명합니다.
- On-demand GPU Service란? 필요한 GPU를 필요할 때 제공받는 방식온디맨드 GPU는 Shared GPU나 Spot GPU와 같은 말이 아닙니다. 요청, 가용 용량, 프로비저닝, 사용량 측정과 반환이 어떻게 연결되는지, 전용 베어메탈도 온디맨드 방식으로 제공할 수 있는지 설명합니다.
- Cloud Service Catalog란? GPU 인프라를 서비스 상품으로 만드는 첫 단계클라우드 서비스 카탈로그는 GPU 재고 목록이나 가격표가 아닙니다. GPU·네트워크·스토리지를 고객이 주문할 수 있는 상품으로 정의하고 정책, 프로비저닝, 과금과 연결하는 구조를 설명합니다.
- 데이터센터가 GPU Hosting에서 GPU Cloud로 전환하려면GPU Hosting에서 GPU Cloud로의 전환은 하드웨어 교체보다 운영 모델 변화에 가깝습니다. 서비스 카탈로그, 셀프서비스, 프로비저닝, 고객 분리, 사용량 측정·과금과 자원 회수를 어떻게 추가해야 하는지 설명합니다.
- 통신사가 보유 GPU 인프라로 자체 AI Cloud Service를 만드는 방법통신사가 보유한 데이터센터·네트워크·GPU 인프라를 고객용 AI Cloud Service로 확장하려면 무엇이 필요할까요? 서비스 상품화, 셀프서비스, 프로비저닝, 고객 분리, 사용량 측정과 운영 구조를 설명합니다.
- Sovereign AI Cloud란? 데이터 위치보다 중요한 통제 범위Sovereign AI는 데이터를 특정 국가에 저장하는 것만으로 완성되지 않습니다. 데이터, 관리자 접근, 키, 인프라, 모델, 운영, 법적 관할과 공급망 의존성을 어떤 범위까지 통제해야 하는지 설명합니다.
- 기업용 AI 인프라 구축 체크리스트: GPU부터 거버넌스까지기업용 AI 인프라는 GPU 구매만으로 완성되지 않습니다. Workload와 Data부터 GPU·Network·Storage, AI Platform, Security·Governance, Operations, Capacity와 Cost까지 12개 실무 항목으로 점검합니다.